| پروژهٔ اولیهٔ این سوال را میتوانید از [این لینک](/contest/assignments/103145/download_problem_initial_project/356751/) دانلود کنید. |
| :-: |
جلوی ورودی ورزشگاهِ **جام جهانی فناوری پردیس ۲۰۲۶** یک تابلوی بزرگ نصب شده که با رسیدن هر تیم، کد آن تیم را نشان میدهد. صبح روز اول نرمافزار تابلو از کار میافتد و تا راهاندازی دوبارهاش، اتاق عملیات باید وارمآپ کند و خودش متن تابلو را تولید کند! هر بار که تیمی وارد میشود، کدش در فایلی به نام `team.txt` نوشته میشود. شما باید یک **اسکریپت** *Bash* بنویسید که این فایل را بخواند و پیام خوشآمدگویی را چاپ کند!
# **پروژهٔ اولیه**
برای دانلود **پروژهٔ اولیه** روی [این لینک](/contest/assignments/103145/download_problem_initial_project/356751/) کلیک کنید. این پروژه فقط یک فایل خالی `solution.sh` دارد که باید آن را کامل کنید.
<details class="grey">
<summary>**نکته: ساختار پروژهٔ اولیه**</summary>
```text tree text
.
└── <mark class="green" title="این فایل را تکمیل کنید.">solution.sh</mark>
```
</details>
# **جزئیات**
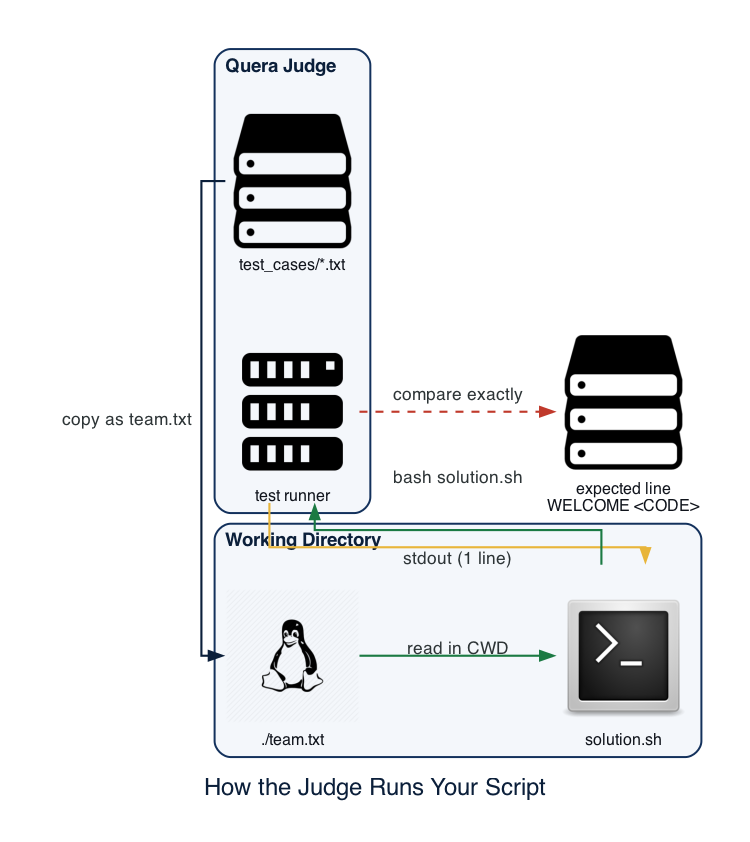
سیستم داوری قبل از اجرا، یک فایل `team.txt` را در **پوشهٔ کاری فعلی** میگذارد و بعد اسکریپت را با دستور `bash solution.sh` اجرا میکند. پس لازم نیست فایل را اجرایی کنید. محتوای `team.txt` روی **ورودی استاندارد** *(stdin)* نمیآید و خود اسکریپت باید آن را بخواند.
|  |
| :-: |
| سیستم داوری کوئرا فایل را میگذارد، اسکریپت را اجرا میکند و خروجی را میسنجد. |
## **فایل ورودی `team.txt`**
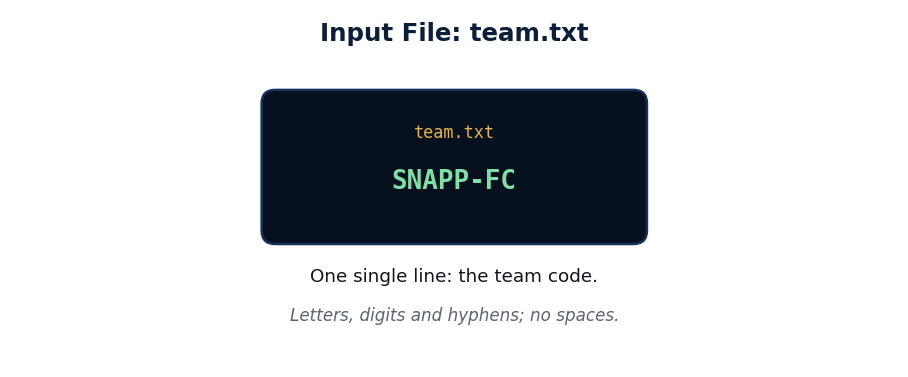
- این فایل دقیقاً **یک خط** دارد و آن خط، کد تیم مهمان است!
- کد تیم فقط از **حروف بزرگ انگلیسی، رقم و خط تیره** ساخته شده و هیچ فاصلهای **ندارد.**
- این فایل همیشه وجود دارد و کد تیم **هیچوقت خالی نیست.**
|  |
| :-: |
| نمونهای از یک کد تیم معتبر: حروف بزرگ، رقم و خط تیره. |
## **خروجی اسکریپت**
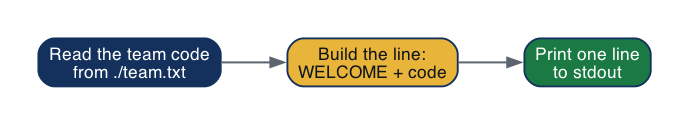
اسکریپت باید **دقیقاً یک خط** چاپ کند: عبارت `WELCOME`، یک فاصله و بعد همان کدی که از فایل خواندهاید.
```text output terminal
WELCOME <TEAM_CODE>
```
> مقدار `<TEAM_CODE>` باید **بدون هیچ تغییری** همان چیزی باشد که داخل `team.txt` نوشته شده. مقایسه عیناً و **حساس به بزرگی و کوچکی** حروف است، پس نه کاراکتر اضافهای دور خط بگذارید و نه خط دومی چاپ کنید.
|  |
| :-: |
| اسکریپت بین فایل ورودی و خروجی استاندارد قرار میگیرد. |
|  |
| :-: |
| همین خط روی تابلوی ورزشگاه نمایش داده میشود. |
# **نمونه**
سه ورودی نمونه و خروجی مورد انتظارشان:
| محتوای `team.txt` | خروجی اسکریپت |
| --: | --: |
| `IRAN` | `WELCOME IRAN` |
| `SNAPP-FC` | `WELCOME SNAPP-FC` |
| `PARDIS2026` | `WELCOME PARDIS2026` |
> خط تیره و رقم داخل کد فرقی نمیکنند؛ کل خط فایل بدون تغییر بعد از `WELCOME` چاپ میشود.
| 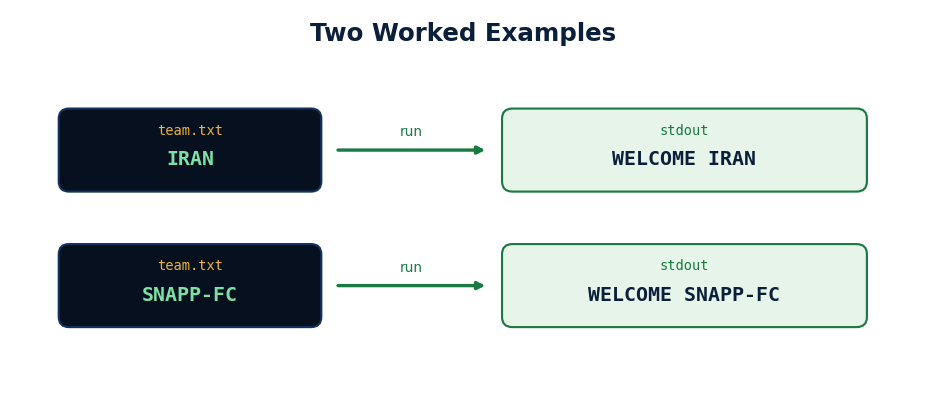 |
| :-: |
| سه نمونه از کد تیم و خروجی متناظرشان. |
فرض کنید فایل `team.txt` که سیستم داوری کنار اسکریپت قرار میدهد به این صورت باشد:
```text team.txt terminal
IRAN
```
با اجرای اسکریپت، خروجی زیر چاپ میشود:
```text output terminal
WELCOME IRAN
```
> در این نمونه فایل `team.txt` تنها یک خط با مقدار `IRAN` دارد. اسکریپت این کد را میخواند و عبارت `WELCOME` را با یک فاصله پیش از آن میآورد و در یک خط چاپ میکند. به همین دلیل خروجی دقیقاً `WELCOME IRAN` میشود و هیچ خط اضافهای در کار نیست. اگر خطای کوچکی مثل یک فاصلهٔ اضافه یا حرف کوچک به خروجی راه پیدا کند، همان بخش رد میشود.
نمونهٔ دوم را با یک کدِ ترکیبی در نظر بگیرید:
```text team.txt terminal
SNAPP-FC
```
خروجی مورد انتظار برابر است با:
```text output terminal
WELCOME SNAPP-FC
```
> اینبار کدِ تیم `SNAPP-FC` است که هم حرف و هم خط تیره دارد، اما برای اسکریپت هیچ فرقی نمیکند. کلِ خطِ فایل بدون تغییر خوانده و بعد از `WELCOME` چاپ میشود، پس خروجی برابر `WELCOME SNAPP-FC` است. همین رفتار برای کدهایی که رقم هم دارند، مانند `PARDIS2026`، برقرار است. نکتهٔ مهم این است که کد را همانطور که هست چاپ کنید و آن را تغییر ندهید.
# **آنچه باید آپلود کنید**
برای ارسال این سوال، فایل `solution.sh` را تکمیل کنید و **همین یک فایل** را در همین صفحه آپلود کنید.
+ **توجه:** تنها فایل `solution.sh` شما در سیستم داوری کوئرا مورد پذیرش قرار میگیرد و تغییر در هر فایل دیگری بیتأثیر است.
+ **توجه:** فایل `solution.sh` بهصورت خودکار توسط سیستم داوری کوئرا اجرا میشود و نیازی به نوشتن دستور دیگری برای اجرای آن **نیست.**
+ **توجه:** سیستم داوری محتوای فایل `team.txt` را بهصورت ورودی استاندارد به اسکریپت نمیدهد، بلکه آن را در پوشهٔ جاری قرار میدهد و خواندن فایل بر عهدهٔ خود اسکریپت است.
+ **توجه:** خروجی باید دقیقاً یک خط و عیناً مطابق قالب خواستهشده باشد. سیستم داوری به **بزرگی** و **کوچکی** حروف **حساس** است.
وارمآپ اتاق عملیات
| پروژهٔ اولیهٔ این سوال را میتوانید از [این لینک](/contest/assignments/103145/download_problem_initial_project/356757/) دانلود کنید. |
| :-: |
هر گیتِ ورودی ورزشگاهِ **جام جهانی فناوری پردیس ۲۰۲۶** یک کارتخوان دارد و هر بار که تماشاگری کارتش را میکشد، یک رویداد ورود یا خروج در لاگ ثبت میشود. در شلوغی روز اول، تابلویی که تعداد افراد داخل سالن را نشان میداد از کار میافتد. تا راهاندازی دوبارهٔ تابلو، سلیب به دو عدد نیاز دارد: **در پایان لاگ چند نفر داخل سالن ماندهاند** و **بیشترین تعداد افرادی که همزمان داخل بودهاند چند نفر بوده است**! یک اسکریپت *Bash* بنویسید که این دو عدد را از روی فایل لاگ محسابه کند.
# **پروژهٔ اولیه**
برای دانلود **پروژهٔ اولیه** روی [این لینک](/contest/assignments/103145/download_problem_initial_project/356757/) کلیک کنید. داخلش یک `solution.sh` هست که چند خط کامنت راهنما دارد و بدنهاش خالی است.
<details class="grey">
<summary>**نکته: تنها فایلی که تحویل میگیرید**</summary>
```text tree text
.
└── <mark class="green" title="این فایل را تکمیل کنید.">solution.sh</mark>
```
</details>
# **جزئیات**
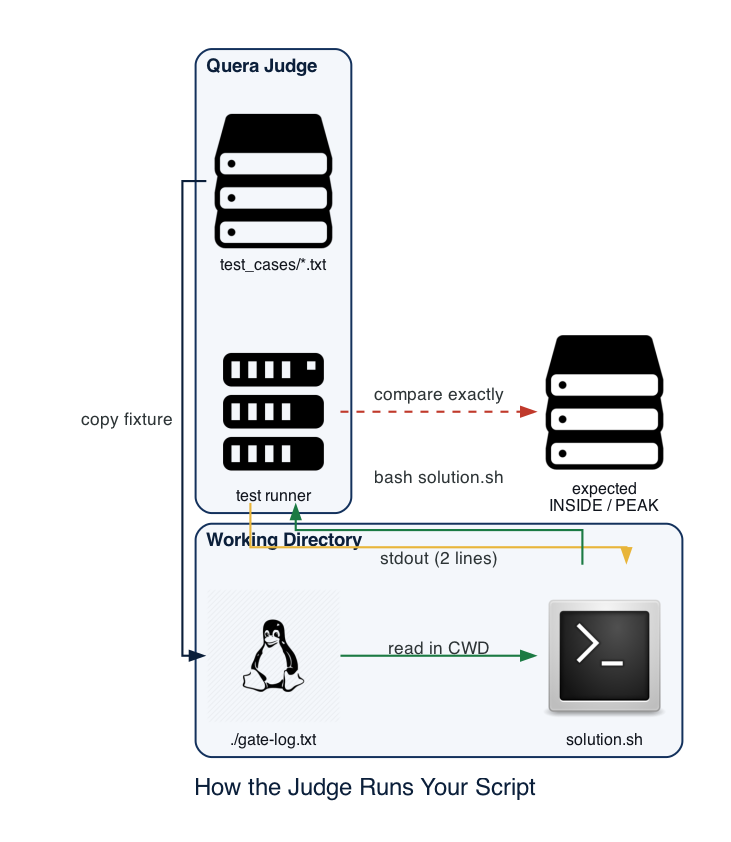
در هر تست، یک `gate-log.txt` جدید در **پوشهٔ کاری فعلی** گذاشته میشود و بعد اسکریپت با دستور `bash solution.sh` اجرا میشود. این فایل روی *stdin* نمیآید، پس اگر کدتان منتظر ورودی بماند، برای همیشه منتظر میماند و سیستم داوری نمرهای برای آن لحاظ **نمیکند!** از کل کاری که اسکریپت میکند، فقط همان دو خطی که چاپ میکند سنجیده میشود و پیادهسازیهای مختلف مورد قبول خواهند بود.
|  |
| :-: |
| سیستم داوری فایل نمونه را در پوشهٔ فعلی میگذارد، اسکریپت را اجرا میکند و دو خط خروجی را عیناً با پاسخ مورد انتظار میسنجد. |
## **قالب فایل `gate-log.txt`**
هر خط از این فایل **یک رویداد کارتخوان** است و از چهار قسمت تشکیل شده که با یک **فاصله** *(space)* از هم جدا میشوند:
```text gate-log.txt terminal
ID GATE BADGE EVENT
```
> سه قسمت اول (`ID` شمارهٔ رویداد، `GATE` نام گیت و `BADGE` شناسهٔ کارت) در این سوال استفاده **نمیشوند.** تنها قسمتی که اهمیت دارد `EVENT` است که دقیقاً یکی از دو مقدار `IN` یا `OUT` را میگیرد. مقدار `IN` یعنی یک نفر **وارد** شده و `OUT` یعنی یک نفر **خارج** شده است. مقدار `IN` یعنی یک نفر وارد سالن شده و `OUT` یعنی یک نفر خارج شده است.
## **منطق شمارش**
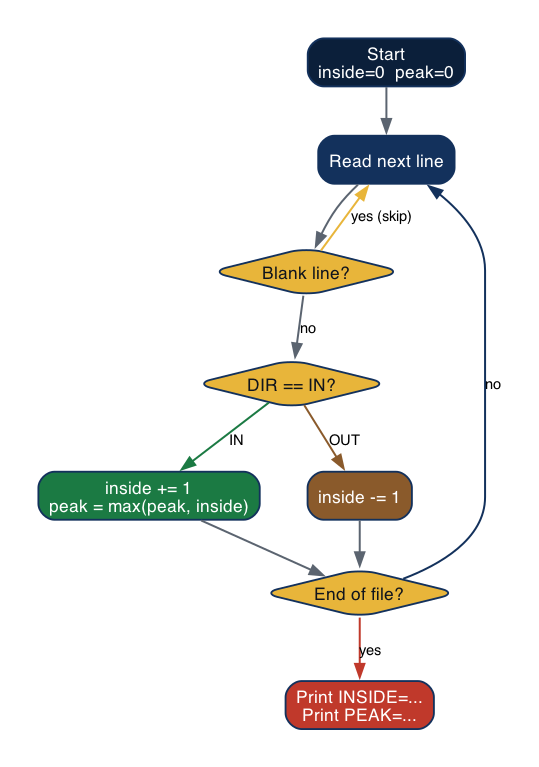
- شمارندهٔ حضور از **صفر** شروع میشود، با هر `IN` یک واحد **افزایش** مییابد و با هر `OUT` یک واحد **کاهش** مییابد.
- همیشه لاگها **سازگار** هستند؛ یعنی هیچوقت بیش از تعداد افرادِ داخل سالن، رویداد خروج ثبت **نمیشود** و شمارنده **هرگز منفی نمیشود.**
- ورودی هر خط همیشه معتبر است و `EVENT` همیشه یکی از دو مقدار `IN` یا `OUT` خواهد بود.
## **دو حالت مرزی که باید مدیریت کنید**
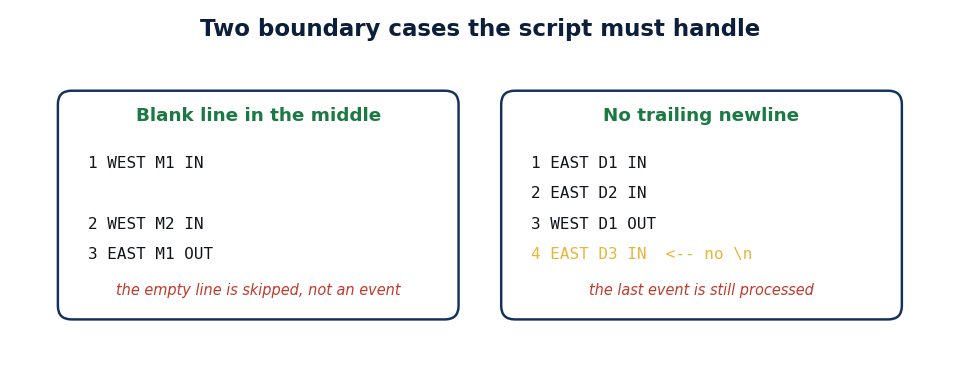
- ممکن است وسط یا انتهای فایل یک **خط کاملاً خالی** بیاید. خط خالی رویداد نیست **و باید نادیده گرفته شود!**
- ممکن است فایل **بدون خط جدید در انتها** تمام شود، یعنی آخرین رویداد بعد از خودش `\n` نداشته باشد. اسکریپت شما باید این آخرین رویداد را هم بخواند و حساب کند.
|  |
| :-: |
| خط خالی بهعنوان رویداد شمرده **نمیشود** و آخرین رویداد حتی بدون خط جدید پایانی باید پردازش شود. |
## **خروجی اسکریپت**
اسکریپت باید **دقیقاً دو خط** و به همین ترتیب چاپ کند:
```text terminal terminal
INSIDE=<count>
PEAK=<max_count>
```
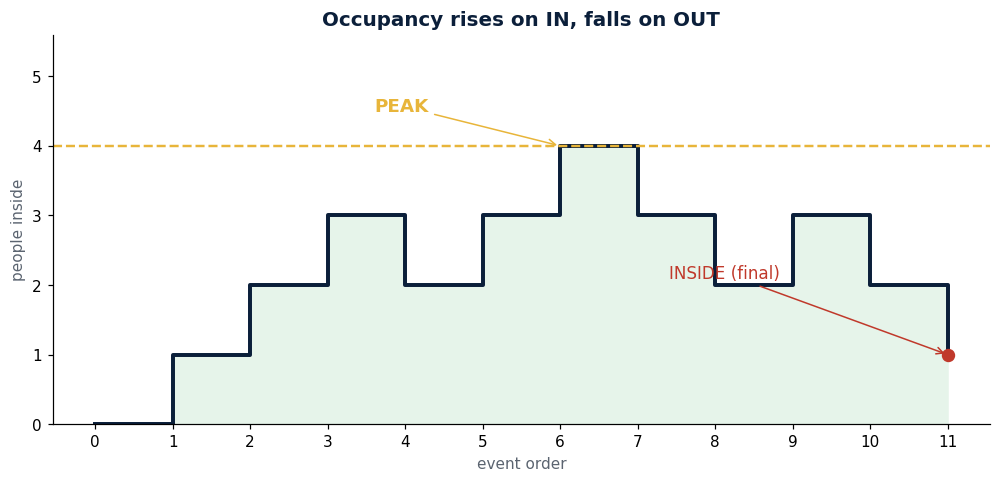
> مقدار `INSIDE` مقدار نهایی شمارندهٔ حضور بعد از پردازش همهٔ رویدادهاست، یعنی تعداد افرادی که در پایان لاگ هنوز **داخل سالن** ماندهاند. مقدار `PEAK` بیشترین عددی است که شمارنده در طول شمارش به آن رسیده است. چون رویداد `OUT` فقط شمارنده را کم میکند، این بیشینه همیشه بلافاصله بعد از یک `IN` رخ خواهد داد. ممکن است در پایان همه سالن را ترک کرده باشند و `INSIDE` صفر شود، ولی `PEAK` همچنان **بیشترین حضور** در طول رویدادها را نگه میدارد!
سیستم داوری خروجی را خطبهخط و **حساس به بزرگی و کوچکی حروف** با پاسخ درست مقایسه میکند. هر فاصلهٔ اضافه، خط سوم یا جابهجایی دو خط باعث رد شدن آن بخش میشود، پس چیزی جز همین دو خط چاپ نکنید.
|  |
| :-: |
| شمارندهٔ حضور با هر ورود افزایش و با هر خروج کاهش مییابد؛ `PEAK` بالاترین نقطهٔ این منحنی و `INSIDE` مقدار پایانی آن است. |
|  |
| :-: |
| منطق پردازش: گذشتن از خط خالی، افزودن یا کاستن شمارنده بر پایهٔ `IN` و `OUT`، بهروزرسانی بیشینه و چاپ دو خط در پایان. |
# **نمونه**
برای مثال، این لاگ سهخطی را در نظر بگیرید:
```text gate-log.txt terminal
1 WEST A1 IN
2 WEST A2 IN
3 EAST A1 OUT
```
با اجرای اسکریپت، خروجی زیر چاپ میشود:
```text output terminal
INSIDE=1
PEAK=2
```
> در این مثال سه رویداد داریم. با دو `IN` پشت سر هم شمارندهٔ حضور به `2` میرسد و همانجا بیشینه برابر `2` ثبت میشود. بعد یک `OUT` شمارنده را به `1` میرساند. در پایان یک نفر داخل سالن مانده، پس `INSIDE=1` و چون بیشترین حضور همزمان `2` نفر بوده `PEAK=2` چاپ میشود.
نمونهٔ دوم را با هفت رویداد در نظر بگیرید که جمعیت اول زیاد و بعد کم میشود:
```text gate-log.txt terminal
1 GATE K1 IN
2 GATE K2 IN
3 GATE K3 IN
4 GATE K4 IN
5 EXIT K1 OUT
6 EXIT K2 OUT
7 EXIT K3 OUT
```
خروجی مورد انتظار برابر است با:
```text output terminal
INSIDE=1
PEAK=4
```
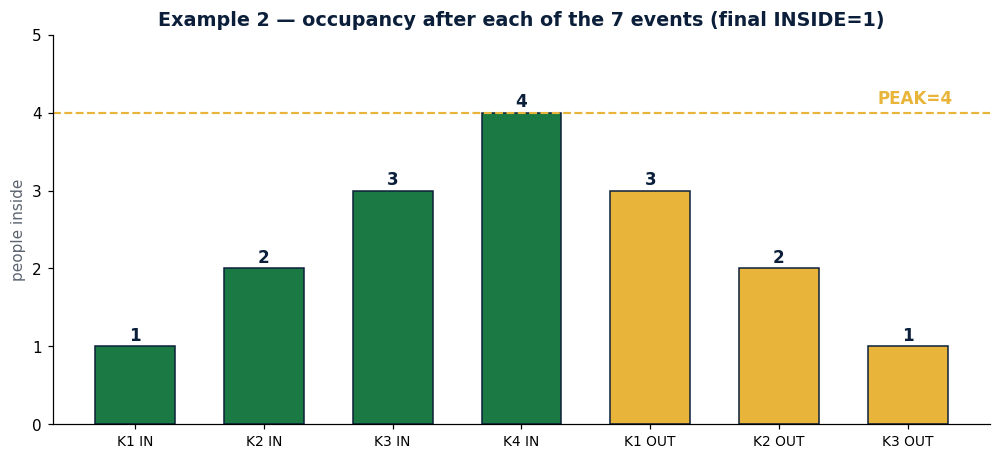
> چهار ورودِ پشت سر هم شمارنده را تا `4` بالا میبرند و بیشینه روی همین `4` باقی میماند. بعد سه خروجِ پشت سر هم شمارنده را به `1` میرسانند. پس در پایان یک نفر داخل سالن است و `INSIDE=1` میشود، اما بیشترین حضور همزمان `4` نفر بوده و `PEAK=4` باقی میماند.
نمونهٔ سوم چند حالت مرزی را یکجا دارد تا هر سه حالت مرزی را یکجا ببینید: یک **خط خالی** وسط فایل، **دو فاصله** بین دو قسمت و **نبودِ خط جدید** در انتهای آخرین خط:
```text gate-log.txt terminal
1 WEST A1 IN
2 EAST A2 IN
3 WEST A1 OUT
4 EAST A3 IN
```
خروجی این یکی برابر است با:
```text output terminal
INSIDE=2
PEAK=2
```
> خط خالی **هیچ رویدادی نیست** و باید اسکیپ شود، نه اینکه بهاشتباه یک رویداد بیمقدار حساب شود. دو فاصلهٔ بین `WEST` و `A1` هم نباید مشکلی درست کند. مهمترین نکتهی این مثال خط آخر است: فایل با `\n` تمام نشده است پس در صورت پیادهسازی اشتباه، رویداد چهارم اصلاً خوانده **نمیشود** و بهجای `INSIDE=2` عدد `1` را چاپ میکنید! سه ورود و یک خروج داریم، پس شمارنده به `2` میرسد و بیشینه هم همان `2` است.
جدول زیر همین نمونه را رویداد به رویداد نشان میدهد:
| رویدادی که خوانده میشود | اثر بر شمارنده | `INSIDE` پس از این رویداد | `PEAK` پس از این رویداد |
| --: | :-: | :-: | :-: |
| `1 GATE K1 IN` | ۱+ | ۱ | ۱ |
| `2 GATE K2 IN` | ۱+ | ۲ | ۲ |
| `3 GATE K3 IN` | ۱+ | ۳ | ۳ |
| `4 GATE K4 IN` | ۱+ | ۴ | ۴ |
| `5 EXIT K1 OUT` | ۱− | ۳ | ۴ |
| `6 EXIT K2 OUT` | ۱− | ۲ | ۴ |
| `7 EXIT K3 OUT` | ۱− | ۱ | ۴ |
همانطور که در ستون آخر میبینید، رویدادهای `OUT` شمارندهٔ حضور را کم میکنند ولی هیچوقت بیشینه را پایین نمیآورند.
|  |
| :-: |
| روند شمارندهٔ حضور در نمونهٔ دوم: صعود تا بیشینهٔ ۴ و سپس نزول تا حضور پایانی ۱. |
# **آنچه باید آپلود کنید**
برای ارسال این تمرین، فایل `solution.sh` را تکمیل کنید و **همین یک فایل** را در همین صفحه آپلود کنید.
+ **توجه:** تنها فایل `solution.sh` شما در سیستم داوری کوئرا مورد پذیرش قرار میگیرد و تغییر در هر فایل دیگری بیتأثیر است.
+ **توجه:** فایل `solution.sh` بهصورت خودکار توسط سیستم داوری کوئرا اجرا میشود و نیازی به نوشتن دستور یا اسکریپت دیگری برای اجرای آن **نیست.**
+ **توجه:** سیستم داوری محتوای فایل `gate-log.txt` را بهصورت ورودی استاندارد به اسکریپت نمیدهد، بلکه آن را در پوشهٔ جاری قرار میدهد و خواندن فایل **بر عهدهٔ خود اسکریپت** است.
+ **توجه:** خروجی باید دقیقاً دو خط و عیناً مطابق قالب خواستهشده باشد. سیستم داوری به بزرگی و کوچکی حروف **حساس** است.
گیتِ سلیبی
| پروژهٔ اولیهٔ این سوال را میتوانید از [این لینک](/contest/assignments/103145/download_problem_initial_project/356752/) دانلود کنید. |
| :-: |
در **مرحلهٔ گروهی جام جهانی فناوری پردیس ۲۰۲۶**، نتیجهٔ هر بازی بلافاصله بعد از سوت پایان ثبت میشود. **دوین** برگزاری میخواهد مطمئن شود که تغییر دادن یک نتیجهٔ ثبتشده **قابل تشخیص** و **دوینآزمایی** باشد! برای همین نتایج در قالب یک **زنجیرهٔ هش** *(hash chain)* ذخیره میشوند: هر رکورد علاوه بر دادهٔ خودش، هش رکورد قبلی را هم نگه میدارد. اگر رکوردی عوض شود ولی هشهای بعدی بهروز نشوند، ناسازگاری از همان نقطه پیدا خواهد بود و لو میرود! شما باید *Bash* اسکریپتی بنویسید که این فایل را بررسی کند و رکوردهای دارای هش **نادرست** و **پیوندهای نامعتبر** را گزارش دهد.
# **پروژهٔ اولیه**
برای دانلود **پروژهٔ اولیه** روی [این لینک](/contest/assignments/103145/download_problem_initial_project/356752/) کلیک کنید. این پروژه شامل یک فایل `solution.sh` با چند خط کامنت راهنما و بدنهٔ خالی است.
<details class="grey">
<summary>**نکته: محتوای پروژهٔ اولیه**</summary>
```
.
└── <mark class="green" title="این فایل را تکمیل کنید.">solution.sh</mark>
```
</details>
# **جزئیات**
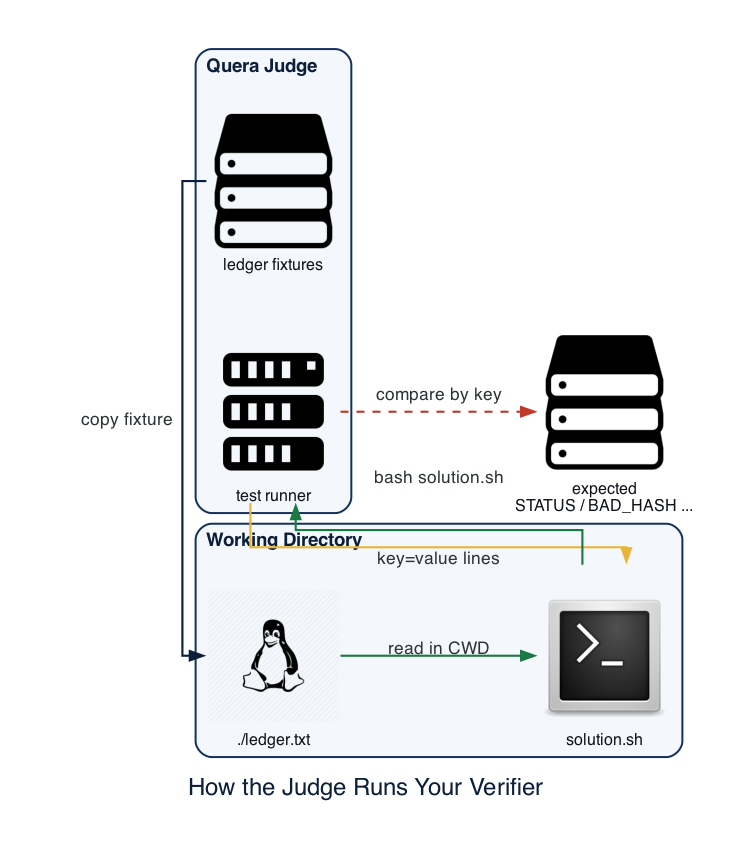
هر تست در سیستم داوری با یک `ledger.txt` جدید در پوشهٔ پروژه شروع میشود و بعد اسکریپت با دستور `bash solution.sh` اجرا میشود. پس **لازم نیست** فایل را اجرایی کنید. چیزی روی *stdin* ظاهر نمیشود؛ خود اسکریپت باید فایل را از مسیر فعلی باز کند. محیط داوری این سوال یک اینستنس *Linux* است و دستور `sha256sum` در محیط داوری نصب میباشد.
|  |
| :-: |
| از فایل ورودی تا پنج مقدار خروجی. |
## **قالب فایل `ledger.txt`**
هر خط فایل یک رکورد است و از چهار قسمت تشکیل شده که با فاصله از هم جدا میشوند:
```text ledger.txt terminal
INDEX PREV_HASH PAYLOAD HASH
```
| قسمت | معنی |
| --: | --: |
| `INDEX` | شمارهٔ رکورد، از `1` شروع شده و افزایش مییابد |
| `PREV_HASH` | هش رکورد قبلی |
| `PAYLOAD` | دادهٔ رکورد، مثلاً `IRAN-PORTUGAL:2-1` |
| `HASH` | هش ذخیرهشدهٔ همین رکورد |
- مقدارهای `PREV_HASH` و `HASH` رشتههای ۶۴ کاراکتری *hex* با **حروف اکیدا کوچکاند.**
- مقدار `PAYLOAD` **نه فاصله دارد** و **نه کاراکتر** `|`، چون `|` جداکنندهٔ ورودی هش است.
- تضمین میشود `INDEX`ها معتبر و بهترتیباند، پس **لازم نیست درستیشان را بررسی کنید**. ولی توجه کنید که `INDEX` در محاسبات فرمول هش استفاده میشود.
- خطهای خالی رکورد **نیستند** و در `ENTRIES` **هم شمرده نمیشوند.**
## **فرمول هشِ هر رکورد:**
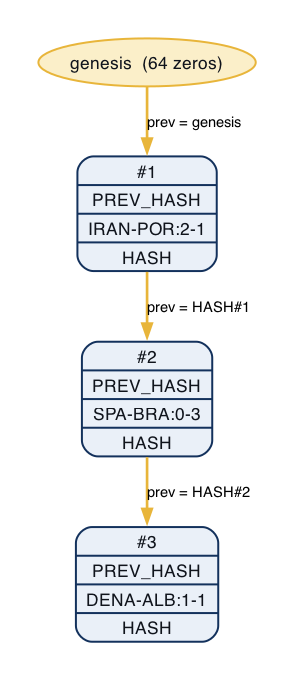
هشِ هر رکورد به این شکل ساخته میشود: سه مقدار `INDEX` و `PREV_HASH` و `PAYLOAD` را با کاراکتر `|` به هم میچسبانید و *SHA-256* آن رشته را میگیرید.
```text hashing terminal
HASH = sha256( "INDEX|PREV_HASH|PAYLOAD" )
```
> نکتهٔ مهم این است که این رشته **هیچ خط جدیدی در انتها ندارد**. اگر آن را با `echo` بسازید، یک `\n` به انتهایش اضافه میشود و هشِ خروجی کاملاً عوض میشود، پس حتماً از `printf '%s'` استفاده کنید.
- برای رکورد اول، مقدار مورد انتظار `PREV_HASH` **یک ثابت به نام** `GENESIS` است: رشتهای شامل دقیقاً ۶۴ کاراکتر `0`.
- برای هر رکورد بعدی، `PREV_HASH` باید برابر `HASH` رکورد خط قبل باشد.
یک فایل سالم سهرکوردی به این شکل است:
```text ledger.txt terminal
1 0000000000000000000000000000000000000000000000000000000000000000 IRAN-PORTUGAL:2-1 b3cab6bb27a591f57af530a2b95e1739cc2b1a5d8a011114b57dbbb110b13714
2 b3cab6bb27a591f57af530a2b95e1739cc2b1a5d8a011114b57dbbb110b13714 SPAIN-BRAZIL:0-3 c1c32daf6f99c6bdbfb769727dc6bd464aaf7f9388dca9c0b4998adc5e597834
3 c1c32daf6f99c6bdbfb769727dc6bd464aaf7f9388dca9c0b4998adc5e597834 DENA-ALBORZ:1-1 88154d4c9b568635f95fe2d87c74c4c5cbb4deadfbc06e52796747dcd626ff9c
```
> با این نمونه میتوانید فرمول هش خود را قبل از ارسال بررسی کنید. هش رکورد اول از رشتهٔ `1|0000...0000|IRAN-PORTUGAL:2-1` ساخته شده و مقدارش `b3cab6bb...` است. اگر همین رشته را با `echo` بسازید یعنی یک `\n` هم به انتهایش اضافه شود، نتیجه `fc21bead...` میشود که کاملاً غلط است. دقت کنید که `PREV_HASH` رکورد دوم دقیقاً همان `HASH` رکورد اول است.
|  |
| :-: |
| هر رکورد هشِ خود را از `INDEX` و `PREV_HASH` و `PAYLOAD` میسازد و رکورد بعدی همین هش را در `PREV_HASH` خود تکرار میکند. |
## **دو بررسی مستقل روی هر رکورد**
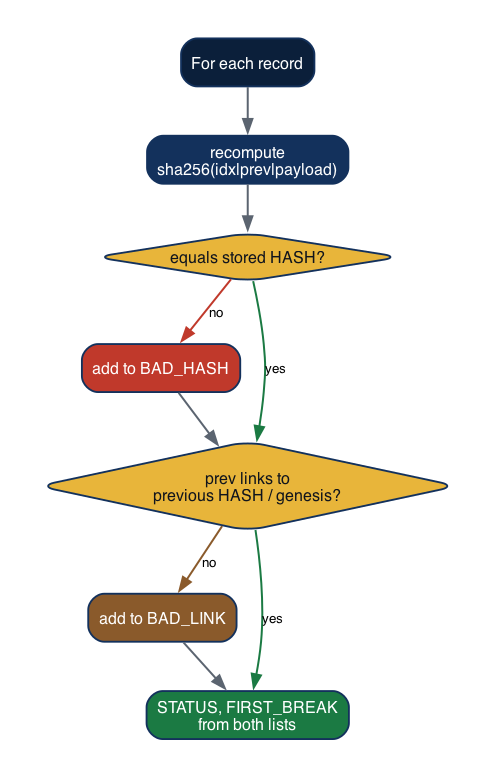
اسکریپت شما باید روی هر رکورد دو بررسی جدا انجام دهد و نتیجه را تفکیکشده گزارش کند:
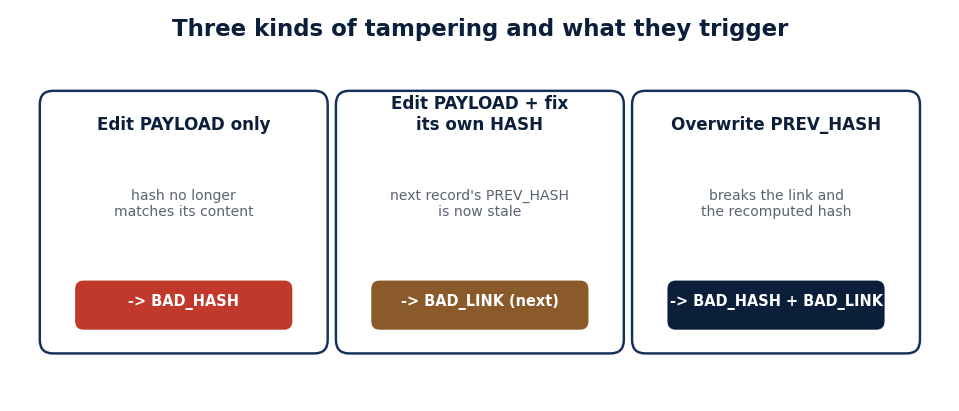
- **درستی هش:** هشِ رکورد را از روی سه مقدار ذخیرهشدهٔ همان خط دوباره حساب کنید و با مقدار `HASH` ذخیرهشده مقایسه کنید. اگر این دو یکسان نبودند، شمارهٔ آن رکورد در فهرست `BAD_HASH` میآید.
- **درست بودن پیوند به رکورد قبلی:** برای رکورد اول، `PREV_HASH` باید برابر `GENESIS` باشد. برای بقیه باید برابر **`HASH` ذخیرهشدهٔ** رکورد خط قبل باشد. اگر برابر نبود، شمارهٔ آن رکورد در فهرست `BAD_LINK` میآید.
+ **توجه:** مقایسه با `HASH` **ذخیرهشدهٔ** رکورد قبلی انجام میشود، نه با هشِ بازمحاسبهشدهٔ آن. یعنی اگر رکورد قبلی خودش خراب باشد ولی مقدار `HASH` نوشتهشدهاش دستنخورده مانده باشد، پیوند رکورد فعلی همچنان معتبر است.
یک رکورد میتواند همزمان در هر دو فهرست بیاید. این حالت ممکن است رخ دهد و باید دقیقاً به همین شکل گزارش شود.
|  |
| :-: |
| دستکاری در متن رکورد بررسیِ هش را میشکند؛ اصلاحِ هش بدون بهروزرسانی رکورد بعدی، سلامتِ حلقه را میشکند. |
## **خروجی اسکریپت**
اسکریپت باید پنج مقدار زیر را، هرکدام در قالب `KEY=VALUE` و هرکدام در یک خط، چاپ کند:
```text output terminal
STATUS=VALID
ENTRIES=5
BAD_HASH=NONE
BAD_LINK=NONE
FIRST_BREAK=NONE
```
> **بلوک بالا یک نمونهٔ کامل از خروجی برای یک فایل سالم است.** سیستم داوری خروجی را **بر پایهٔ کلید** میخواند، پس ترتیب خطها اهمیتی ندارد، ولی نام کلیدها و قالب مقدارها باید دقیق باشد. هر پنج کلید همیشه باید چاپ شوند، حتی وقتی مقدارشان `NONE` است.
معنی هر کلید به این شرح است:
| **کلید** | **مقدار** |
| --: | --: |
| `STATUS` | اگر هیچ رکوردی نه در `BAD_HASH` و نه در `BAD_LINK` نبود `VALID`، **در غیر این صورت** `BROKEN` |
| `ENTRIES` | تعداد کل رکوردهای فایل |
| `BAD_HASH` | شمارههای رکوردهایی که هششان نمیخواند، مرتب صعودی و جداشده با یک فاصله، یا `NONE` |
| `BAD_LINK` | شمارههای رکوردهایی که پیوندشان به رکورد قبلی درست نیست، مرتب صعودی و جداشده با یک فاصله، یا `NONE` |
| `FIRST_BREAK` | کوچکترین شمارهای که در `BAD_HASH` یا `BAD_LINK` آمده، یا `NONE`. این مقدار فقط کمترین شمارهٔ مشکلدار است و علت خرابی را مشخص نمیکند |
+ **«شمارهٔ رکورد» یعنی چه؟** هر جا در `BAD_HASH` و `BAD_LINK` و `FIRST_BREAK` از شمارهٔ رکورد حرف میزنیم، منظور **مقدار فیلد `INDEX` همان خط** است، نه شمارهٔ ترتیبی خط در فایل. چون خط خالی ممکن است وسط فایل بیاید، **این دو الزاماً یکی نیستند!**
## **سه حالت مرزی که باید در نظر بگیرید:**
- خطهای کاملاً خالی وسط یا انتهای فایل باید **نادیده** گرفته شوند.
- ممکن است فایل بدون خط جدید در انتها تمام شود و آخرین رکورد باید همچنان خوانده شود.
- ممکن است **در ابتدای خط، انتهای خط و بین قسمتها** فاصلههای اضافه باشد. اسکریپت باید همه را تحمل کند. اگر با `cut -d' '` جدا کنید میشکند؛ `read -r` یا `awk` بدون `-F` این حالت را خودشان مدیریت میکنند.
|  |
| :-: |
| برای هر رکورد، هش بازمحاسبه و حلقه بررسی میشود؛ در پایان پنج مقدار خروجی از دو فهرست ساخته میشوند. |
# **نمونه**
فرض کنید فایلی با پنج رکورد داریم. چهار حالت زیر تفاوت این دو بررسی را روشن میکند.
خروجی فایل سالم همان است که در بخش چهارم دیدید: هر دو فهرست `NONE`، `STATUS=VALID` و `FIRST_BREAK=NONE`.
حالا چند نوع دستکاری روی همان فایل:
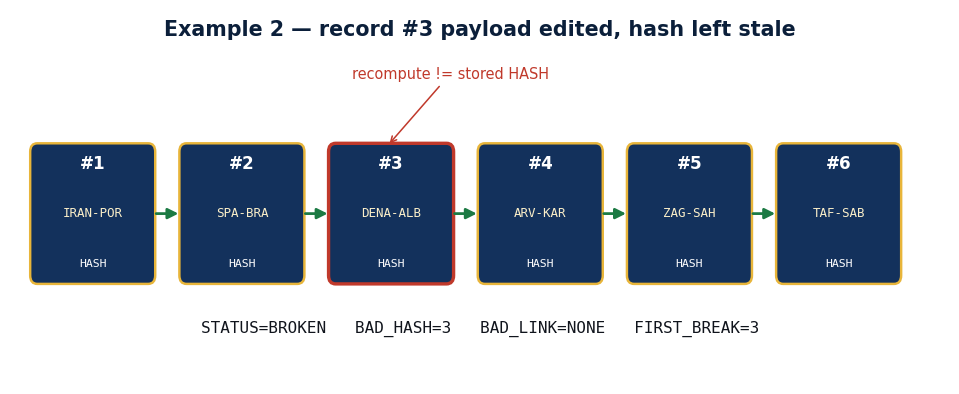
**حالت اول، فقط `PAYLOAD` رکورد ۳ عوض شده و هشش بهروز نشده:**
```text output terminal
STATUS=BROKEN
ENTRIES=5
BAD_HASH=3
BAD_LINK=NONE
FIRST_BREAK=3
```
> بازمحاسبهٔ هش رکورد ۳ عدد دیگری میدهد، پس `3` در `BAD_HASH` میآید. اما مقدار `HASH` نوشتهشدهٔ رکورد ۳ دستنخورده مانده و رکورد ۴ هنوز به همان عدد قدیمی اشاره میکند، پس پیوندش معتبر است و `BAD_LINK` خالی میماند.
**حالت دوم، `PAYLOAD` رکورد ۳ عوض شده و هشِ خودش هم درست بازمحاسبه شده:**
```text output terminal
STATUS=BROKEN
ENTRIES=5
BAD_HASH=NONE
BAD_LINK=4
FIRST_BREAK=4
```
> اینبار رکورد ۳ با هش خودش سازگار است، پس اصلاً در `BAD_HASH` نمیآید. ولی چون `HASH` رکورد ۳ عوض شده و `PREV_HASH` رکورد ۴ هنوز عدد قدیمی را دارد، پیوند رکورد ۴ میشکند. دقت کنید که رکورد گزارششده `4` است، در حالی که رکوردی که واقعاً دستکاری شده `3` بوده.
**حالت سوم، فقط `PREV_HASH` رکورد ۴ عوض شده:**
```text output terminal
STATUS=BROKEN
ENTRIES=5
BAD_HASH=4
BAD_LINK=4
FIRST_BREAK=4
```
> اینجا رکورد `4` در **هر دو** فهرست میآید. دلیلش این است که `PREV_HASH` هم بخشی از ورودی فرمول هش است، پس عوض شدنش هم پیوند به رکورد قبل را میشکند و هم باعث میشود هش بازمحاسبهشدهٔ خود رکورد ۴ با `HASH` ذخیرهشدهاش نخواند. همین حالت است که در بخش سوم گفته شد یک رکورد میتواند در هر دو فهرست بیاید.
**حالت چهارم، دو دستکاری جدا در یک فایل:**
سه حالت قبلی هرکدام یک عیب داشتند. در عمل ممکن است چند جای فایل همزمان خراب باشد و آن وقت هر سه فهرست با هم پر میشوند. فرض کنید در همان فایل پنجرکوردی، `PAYLOAD` رکورد ۲ عوض شده بدون بهروز شدن هشش و جدا از آن `PREV_HASH` رکورد ۵ هم دستکاری شده:
```text output terminal
STATUS=BROKEN
ENTRIES=5
BAD_HASH=2 5
BAD_LINK=5
FIRST_BREAK=2
```
> در این مثال سه نکته مهم است. اول اینکه `BAD_HASH` دو شماره دارد و باید **صعودی و با یک فاصله** جدا شوند. دوم اینکه رکورد `5` همزمان در هر دو فهرست آمده، چون دستکاری `PREV_HASH` هم اتصالش را میشکند و هم هش خودش را. سوم اینکه `FIRST_BREAK` برابر `2` است، یعنی کوچکترین شماره از **اجتماع** دو فهرست، نه کوچکترین شمارهٔ `BAD_LINK`. نکتهٔ ظریف اینجاست که رکورد ۳ سالم میماند: `HASH` رکورد ۲ دستنخورده مانده، پس پیوند رکورد ۳ به آن همچنان درست است.
|  |
| :-: |
| نمونهای از یک فایل که متن رکورد سومش عوض شده و هشش بهروز نشده است. |
# **سابتسکهای سوال**
امتیاز این سؤال در قالب **ده سابتسک** مستقل پخش شده و هر کدام به صورت جدا محسابه میشود:
| **سابتسک** | **درصد** |
| --: | :-: |
| تشخیص درست یک زنجیرهٔ سالم | ۱۰ |
| گزارش تعداد ردیفها | ۸ |
| پیدا کردن دستکاری متن با هش خودِ ردیف | ۱۴ |
| بررسی درست پیوند ردیف اول به هش صفر | ۸ |
| پیدا کردن گسست پیوند بین دو ردیف | ۱۴ |
| گزارش شمارهٔ اولین ردیف خراب | ۱۰ |
| فهرست مرتب همهٔ ردیفهای خراب | ۱۲ |
| اعلام وضعیت خراب وقتی هر دستکاریای هست | ۸ |
| تاب آوردن در برابر فاصلهٔ اضافه و نبودن خط پایانی | ۸ |
| مقایسهٔ کامل با مرجع روی یک فایل بزرگ | ۸ |
> ترتیب این جدول **تصادفی نیست** و تقریباً همان ترتیبی است که **پیشنهاد** میشود در حل سوال پیش بروید. اگر فقط تشخیص زنجیرهٔ سالم و شمارش ردیفها را درست کنید، تا حدود ۲۰ درصد از امتیاز را خواهد گرفت بدون اینکه سراغ پیدا کردن دستکاری بروید.
# **آنچه باید آپلود کنید**
فایل `solution.sh` را کامل کنید و **همین یک فایل** را بفرستید.
+ **توجه:** سیستم داوری کوئرا فقط `solution.sh` را برمیدارد و بقیهٔ فایلهای ارسالی را دور میریزد.
+ **توجه:** برای ساخت ورودی هش حتماً از `printf '%s'` استفاده کنید تا خط جدید اضافهای وارد آن نشود.
+ **توجه:** سیستم داوری خروجی را بر پایهٔ کلیدها میخواند، ولی نام کلیدها، واژهٔ `NONE` و **مرتب بودن صعودی فهرستها باید دقیق باشد.**
+ **توجه:** اسکریپت باید نسبت به خطهای خالی، نبودِ خط جدید پایانی و فاصلههای اضافه بین قسمتها **مقاوم** باشد.
زنجیر دوینآزمایی
| پروژهٔ اولیهٔ این سوال را میتوانید از [این لینک](/contest/assignments/103145/download_problem_initial_project/356755/) دانلود کنید. |
| :-: |
در **جام جهانی فناوری پردیس ۲۰۲۶** آنقدر خبرنگار و بازیکن و داور و مهمان ویژه در ورزشگاه رفتوآمد دارند که دیگر نمیشود دستی کنترل کرد چه کسی اجازهٔ ورود به کدام قسمت را دارد. بهجای دفترچه و مهر و امضا، قرار است یک **ابزار خط فرمان** ساخته شود که کارتها را صادر کند، ماتریس دسترسی را نگه دارد و در لحظهٔ ورود تصمیم بگیرد که این کارت اجازهٔ ورود به موقعیت مشخص را دارد یا نه.
این ابزار باید روی یک سرور خالیِ اتاق عملیات کار کند: نقطهٔ ورود و منطق دستورها با *Bash* و بدون هیچ بستهٔ نصبی از بیرون. سرور فقط چیزهایی را دارد که روی هر ماشین لینوکسی هست و کار شما ساختن این ابزار با همان چیزهاست. کل وضعیت رویداد در یک **دیتابیس SQLite** ذخیره میشود تا چند گیت ورودی بتوانند همزمان به آن دست بزنند بدون اینکه ظرفیت موقعیتها دوبارهشماری شود. اسم این ابزار `accred` است و شما باید آن را از پایه بنویسید!
+ **این سوال، سوالی بسیار سخت و با پیادهسازی مفصل و وقتگیر است!** لازم نیست همهچیز را پیادهسازی کنید. هر گروه از دستورها امتیاز مستقل خودش را دارد و میتوانید از هرجا که راحتترید شروع کنید. جدول «سابتسکها» در انتهای سوال نشان میدهد هر بخش چند درصد از امتیاز سوال را دارد.
# **پروژهٔ اولیه**
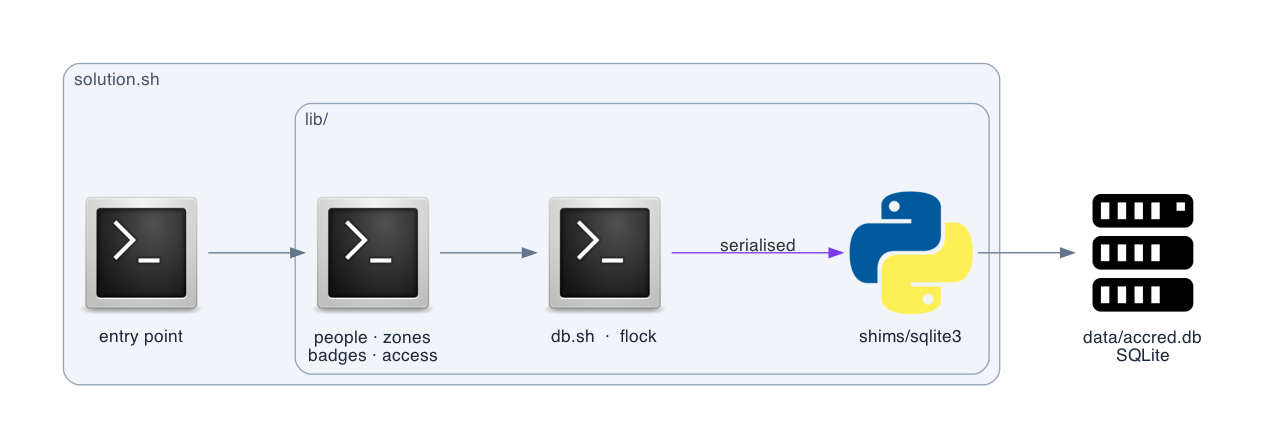
برای دانلود **پروژهٔ اولیه** روی [این لینک](/contest/assignments/103145/download_problem_initial_project/356755/) کلیک کنید. برخلاف سؤالهای قبلی، پروژه اولیه این سؤال یک تکفایل نیست؛ یک **درخت پروژهٔ چندفایلی** است که خودتان میسازید: یک نقطهٔ ورود `solution.sh` که دستور را میگیرد و به ماژول درست میسپارد، بههمراه چند ماژول کمکی در پوشهٔ `lib/`.
<details class="grey">
<summary>**نکته: یک چیدمان پیشنهادی برای ماژولها**</summary>
نام و مرزبندی ماژولها کاملاً دلخواه شماست. آنچه سنجیده میشود **رفتار دستورهاست**، نه نام فایلها. درخت زیر فقط یک پیشنهاد است:
```
.
├── <mark class="green" title="فایل اصلی و نقطه ورود برنامه؛ این فایل را تکمیل کنید.">solution.sh</mark>
└── lib/
├── <mark class="green" title="توابع کمکی شامل کدهای خروج، اعتبارسنجی آرگومانها و logging؛ این فایل را تکمیل کنید.">util.sh</mark>
├── <mark class="green" title="لایه دسترسی به دیتابیس SQLite که عملیات را با flock بهصورت سریالی انجام میدهد؛ این فایل را تکمیل کنید.">db.sh</mark>
├── <mark class="green" title="تعریف ساختار و جداول دیتابیس SQLite؛ این فایل را تکمیل کنید.">schema.sql</mark>
├── <mark class="green" title="مدیریت افراد و zoneها؛ این فایل را تکمیل کنید.">people.sh</mark>
├── <mark class="green" title="مدیریت ماتریس دسترسی و مجوزهای ورود؛ این فایل را تکمیل کنید.">perms.sh</mark>
├── <mark class="green" title="صدور و لغو badgeها؛ این فایل را تکمیل کنید.">badges.sh</mark>
├── <mark class="green" title="موتور بررسی دسترسی و مدیریت occupancy لحظهای؛ این فایل را تکمیل کنید.">access.sh</mark>
├── <mark class="green" title="ورود و خروجی گرفتن دادهها در قالب JSON و CSV؛ این فایل را تکمیل کنید.">io.sh</mark>
├── <mark class="green" title="اعتبارسنجی، تولید integrity hash، پشتیبانگیری و دریافت آمار؛ این فایل را تکمیل کنید.">integrity.sh</mark>
├── <mark class="green" title="پیادهسازی TCP daemon فقط برای خواندن اطلاعات؛ این فایل را تکمیل کنید.">serve.sh</mark>
├── <mark class="green" title="Helper پایتون برای پردازش JSON؛ این فایل را تکمیل کنید.">jsonio.py</mark>
└── shims/
└── <mark class="green" title="جایگزین Python برای sqlite3 CLI؛ این فایل را تکمیل کنید.">sqlite3</mark>
```
</details>
# **جزئیات**
ابزار همیشه به این شکل اجرا خواهد شد:
```bash terminal terminal
./solution.sh <command> [args...]
```
> فایل `solution.sh` باید ماژولهای `lib/` را با `source` بارگذاری کند. برای پیدا کردن `lib/` مسیر **خود اسکریپت** را حساب کنید، نه پوشهٔ کاری، وگرنه اجرای ابزار از یک پوشهٔ دیگر دچار مشکل خواهد شد. مسیر پوشهٔ داده از متغیر محیطی `ACCRED_DATA_DIR` خوانده میشود و اگر ست نشده بود پیشفرضش `data` در پوشهٔ کاری است. سیستم داوری همیشه این متغیر را روی یک پوشهٔ موقت ست میکند، پس حتماً از آن بخوانید و مسیر را **هاردکد نکنید.**
+ **قفل:** همهٔ عملیات نوشتن باید روی **یک فایل قفل مشترک** داخل همان پوشهٔ داده انجام شوند، مثلاً `$ACCRED_DATA_DIR/.accred.lock`. همهٔ پردازهها باید روی یک فایل قفل مشترک هماهنگ شوند؛ اگر هرکدام قفل جدا بگیرند، هماهنگی برقرار نمیشود.
+ **اولین اجرا:** اگر پوشهٔ داده یا فایل `accred.db` وجود نداشته باشد، ابزار باید خودش آنها را بسازد و اسکیما را اعمال کند. اولین اجرای هر دستور، حتی `list-zones`، باید در صورت نبودن `data/` و `accred.db` آنها را بسازد و اسکیما را اعمال کند.
|  |
| :-: |
| نقطهٔ ورود، ماژولهای دامنه و لایهٔ دادهٔ *SQLite* که همهٔ دسترسیها را با `flock` سریالی میکند. |
## **محیط اجرای سیستم داوری**
**این مهمترین محدودیت این سؤال است و اگر به آن دقت نکنید، هیچکدام از دستورها کار نخواهند کرد.**
محیط داوری *Linux* است و علاوه بر ابزارهای معمول *GNU coreutils* مثل `sort` و `uniq` و `cut` و `paste`، اینها هم تضمینشده در دسترساند: `bash`، `python3`، `flock`، `sha256sum` و `awk`.
ولی ابزارهای خط فرمانِ `sqlite3`، `jq` و `nc` روی داور **نصب نیستند**. پایتون ۳ ماژولهای `sqlite3` و `json` و `socket` را بهصورت درونساخت دارد، پس هر سه کار با پایتون شدنی است.
+ **پس این سؤال دقیقاً چقدر بش است؟** بدنه اسکلت ابزار، تجزیهٔ آرگومانها، درخت تصمیم `check`، قفلگذاری با `flock` و چاپ خروجیها همه بشاند و بخش عمدهٔ کد را میسازند. ولی چندجا ناگزیر باید چند خطی پایتون بنویسید: پل زدن به *SQLite،* ساخت و خواندن *JSON* و گوش دادن روی سوکت *TCP*. این چالش عمداً طراحی شده و همان مهارتی است که سنجیده میشود: وقتی ابزار دلخواهتان روی سروری نیست و نمیتواند هم باشد، با چیزی که هست سر میکنید. پس اگر انتظار یک چالش صددرصد بش داشتید، بدانید که نوشتن چند قطعهٔ پایتونی هم لازم خواهد شد...
+ **توجه:** برای کار با *SQLite* یک اسکریپت پایتونی جایگزینِ `sqlite3` در `lib/shims/` بسازید و ابتدای `PATH` قرارش دهید تا بقیهٔ کدتان طوری بنویسد که انگار `sqlite3` واقعی وجود دارد.
+ **توجه:** برای ساخت و خواندن *JSON* از ماژول `json` پایتون استفاده کنید، نه `jq`.
+ **توجه:** برای گوش دادن روی پورت *TCP* از ماژول `socket` پایتون استفاده کنید، نه `nc`.
<details class="pink">
<summary>**راهنمایی: ساختن جایگزین `sqlite3` با پایتون**</summary>
لازم نیست کل رفتار `sqlite3` را بنویسید. فقط همین زیرمجموعهای که کد خودتان استفاده میکند کافی است: مسیر دیتابیس را از آرگومان اول بگیرد، کوئری را از آرگومان دوم یا از ورودی استاندارد بخواند و نتیجهٔ هر سطر را با جداکنندهٔ `|` چاپ کند.
```python lib/shims/sqlite3 python
#!/usr/bin/env python3
import sqlite3, sys
db = sys.argv[1]
script = sys.argv[2] if len(sys.argv) > 2 else sys.stdin.read()
con = sqlite3.connect(db, timeout=30)
con.execute("PRAGMA foreign_keys = ON")
cur, buf = con.cursor(), ""
for chunk in script.split(";"):
buf += chunk + ";"
if not <mark class="yellow" title="تا وقتی دستور کامل نشده، تکهها را روی هم جمع میکند">sqlite3.complete_statement(buf)</mark>:
continue
if buf.strip(" \t\r\n;"):
cur.execute(buf)
for row in cur.fetchall():
print("|".join("" if v is None else str(v) for v in row))
buf = ""
con.commit()
con.close()
```
> این اسکریپت مسیر دیتابیس را از آرگومان اول میگیرد و کوئری را یا از آرگومان دوم یا از ورودی استاندارد میخواند، بعد آن را به دستورهای جداگانه میشکند و هر کدام را جدا اجرا میکند. خروجی هر سطر را با جداکنندهٔ `|` چاپ میکند، دقیقاً مثل حالت پیشفرض `sqlite3`. بعد از ساختن فایل، با `chmod +x` اجراییاش کنید و در `solution.sh` مسیر `lib/shims` را ابتدای `PATH` بگذارید.
+ **چرا با `complete_statement` و نه با `executescript`؟** چون `executescript` در پایتون هیچ سطری برنمیگرداند. اگر با آن بنویسید، دستوری مثل `UPDATE ...; SELECT changes();` بدون هیچ پیام خطایی خروجی خالی میدهد و پیدا کردن این باگ ساعتها وقت میگیرد. تابع `complete_statement` هم هوشمندتر از `split` ساده است و نقطهویرگولِ داخل رشتهها را اشتباهاً مرز دستور حساب نمیکند. نسخهٔ بالا حداقلی است و اگر کد شما به قابلیت دیگری از `sqlite3` نیاز داشت، خودتان میتوانید اضافهاش کنید.
</details>
## **اسکیمای دیتابیس**
سیستم داوری برای ساختن سناریوهای خراب، **مستقیم به دیتابیس شما وصل میشود و در جدولها `INSERT` و `UPDATE` میزند**. به همین دلیل نام فایل دیتابیس و نام این سه جدول و ستونهایشان اجباری است:
| مورد | مقدار اجباری |
| --: | --: |
| مسیر فایل دیتابیس | `$ACCRED_DATA_DIR/accred.db` |
| جدول کارتها | `badges` با ستونهای `serial`، `person`، `status` |
| جدول ماتریس دسترسی | `permissions` با ستونهای `role`، `zone` |
| جدول حضور | `occupancy` با ستونهای `zone`، `inside` |
بقیهٔ جدولها (افراد، موقعیتها، لاگ ورود، لاگ تغییرات) را با هر نام و ستونی که خواستید بسازید. لایهٔ ذخیرهسازی را عمداً کمقید نگه دارید تا دادهای که از بیرون وارد یا دستی ویرایش شده بهجای رد شدن، بعداً با دستور `validate` پیدا شود.
| 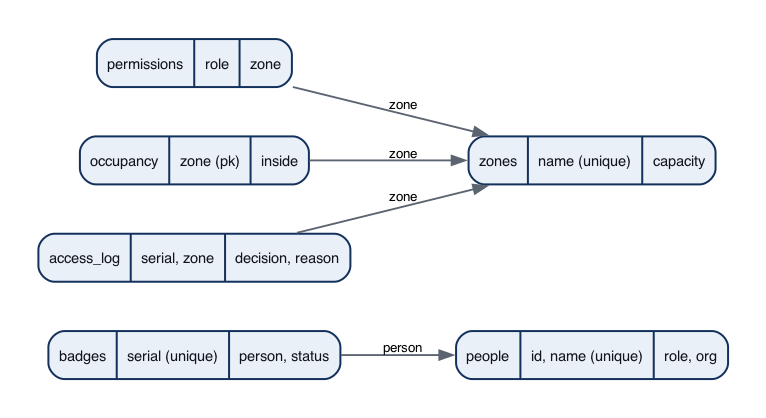 |
| :-: |
| جدولهای سامانه و پیوندهای منطقی بین افراد، کارتها، موقعیتها، ماتریس دسترسی و حضور. |
## **کدهای خروج**
همهٔ دستورها از یک قاعدهٔ مشترک برای کد خروج پیروی میکنند:
| **کد خروج** | **معنی** |
| :-: | --: |
| `0` | موفقیت |
| `1` | خطای استفاده یا مقدار **نامعتبر** (دستور ناشناخته، بدون آرگومان، ظرفیت منفی، نام تکراری) |
| `2` | ارجاع به چیزی که وجود **ندارد** (فرد، موقعیت یا فایل ناشناخته) |
| `3` | شکست یکپارچگی، یعنی وقتی `validate` مشکلی پیدا کند |
- **توجه:** پیامهای خطا روی **خروجی خطا** *(stderr)* چاپ میشوند و نباید در خروجی استاندارد بیایند.
## **دستورهای ساختاری**
| **دستور** | **کار** | **رفتار مورد انتظار** |
| --: | --: | --: |
| `help` | چاپ راهنمای ابزار | کد خروج `0` و دستکم یک خط که واژهٔ `accred` در آن باشد |
| هر دستور ناشناخته | مثلاً `no-such-command` | کد خروج `1` |
| اجرا بدون هیچ آرگومان | `./solution.sh` | کد خروج `1` |
روی یک دیتابیس خالی، `list-zones` باید با کد خروج `0` و **بدون هیچ خط خروجی** تمام شود.
## **افراد، موقعیتها و ماتریس دسترسی**
| دستور | کار | خروجی |
| --: | --: | --: |
| `add-person <name> <role> [org]` | ثبت یک فرد با نقش و سازمان اختیاری | `PERSON <name> <role> <org>` |
| `list-people [role]` | فهرست افراد **به ترتیب ثبت**، با فیلتر اختیاری نقش | هر خط: `<name> <role> <org>` |
| `add-zone <name> <capacity>` | تعریف یک موقعیت با ظرفیت | `ZONE <name> <capacity>` |
| `list-zones` | فهرست موقعیتها **مرتب شده بر اساس نام** | هر خط: `<name> <capacity> <inside>` |
| `grant <role> <zone>` | مجاز کردن یک نقش برای یک موقعیت | `GRANT <role> <zone>` |
| `revoke-perm <role> <zone>` | برداشتن مجوز یک نقش از یک موقعیت | `REVOKE-PERM <role> <zone>` |
| `permissions [role]` | ماتریس دسترسی، **مرتب شده بر اساس نقش و بعد موقعیت** | هر خط: `<role> <zone>` |
| `who-can-enter <zone>` | افرادِ دارای کارت فعال و نقش مجاز برای یک موقعیت | هر خط: `<name> <role>` مرتب شده بر اساس نام |
قواعدی که باید رعایت شوند:
- اگر `org` داده نشود، در خروجی بهجایش کاراکتر `-` میآید. مثلاً `add-person Vahid VIP` خروجی `PERSON Vahid VIP -` میدهد.
- ثبت فردی با **نام تکراری** رد میشود و کد خروج `1` میدهد.
- ظرفیت موقعیت باید یک **عدد صحیح نامنفی** باشد. مقدارهایی مثل `-1` یا `abc` کد خروج `1` میدهند.
- دستور `grant` روی موقعیتی که وجود ندارد کد خروج `2` میدهد. `leave` هم روی موقعیت ناشناخته همین `2` را میدهد. قاعدهٔ کلی این است که **هر ارجاع به چیزی که وجود ندارد** کد `2` میگیرد، چه در دستور خواندنی باشد چه نوشتنی.
- دستور `who-can-enter` روی موقعیت ناشناخته کد خروج `2` میدهد و کسانی را که کارتشان باطل شده در فهرست نمیآورد.
## **کارتها و منطق تصمیم ورود**
نام هر فرد در کل سامانه **یکتاست**. اگر `add-person` با نامی صدا زده شود که از قبل ثبت شده، باید آن را **رد کند** و کد خروج `1` بدهد، نه اینکه نقش یا سازمانش را بهروز کند. سریال هر کارت هم به همین شکل یکتاست.
هر فرد میتواند یک یا چند کارت با سریال یکتا داشته باشد. کارت تا وقتی **باطل** نشده وضعیت `ACTIVE` دارد. مهمترین دستور این سامانه `check` است که تصمیم ورود را میگیرد و اگر پذیرفت، تعداد افراد داخل آن موقعیت را یکی زیاد میکند.
| **دستور** | **کار** | **خروجی** |
| --: | --: | --: |
| `issue <person> <serial>` | صدور کارت برای یک فرد | `BADGE <serial> <person> ACTIVE` |
| `revoke <serial>` | باطل کردن یک کارت | `BADGE <serial> <person> REVOKED` |
| `list-badges [person]` | فهرست کارتها **مرتب شده بر اساس سریال** | هر خط: `<serial> <person> <status>` |
| `check <serial> <zone>` | تلاش برای ورود | `<GRANTED>` یا `<DENIED>` و بعد `<serial> <zone> <reason>` |
| `leave <serial> <zone>` | خروج از یک موقعیت | `LEFT <serial> <zone>` |
| `occupancy [zone]` | تعداد افراد داخل | هر خط: `<zone> <inside>/<capacity>` |
| `access-report [zone]` | شمار پذیرش و رد | هر خط: `<zone> GRANTED=<g> DENIED=<d>` |
دستور `check` شرطها را **به همین ترتیب** بررسی میکند و `reason` یکی از این پنج مقدار میشود:
| ترتیب بررسی | شرط | مقدار `reason` | نتیجه |
| :-: | --: | --: | --: |
| ۱ | کارت اصلاً وجود ندارد | `NO_BADGE` | `DENIED` |
| ۲ | کارت باطل شده است | `REVOKED` | `DENIED` |
| ۳ | نقشِ دارندهٔ کارت برای این موقعیت مجاز نیست | `NOT_PERMITTED` | `DENIED` |
| ۴ | موقعیت پر است | `ZONE_FULL` | `DENIED` |
| ۵ | هیچکدام از بالا | `OK` | `GRANTED` |
- **دستور** `check` همیشه با کد خروج `0` تمام میشود، چون **رد شدن یک تصمیم عادی است، نه خطا**. فقط موقعیت ناشناخته کد خروج `2` میدهد.
- هر `check` که به `DENIED` برسد نباید تعداد افراد داخل موقعیت را عوض کند.
- موقعیتی با ظرفیت `0` همه را رد میکند و دلیلش `ZONE_FULL` است.
- **دستور** `leave` فقط تعداد افراد داخل موقعیت را یکی کم میکند و **هرگز زیر صفر نمیرود**. این دستور بررسی نمیکند که آن کارت واقعاً داخل موقعیت بوده یا نه؛ فقط وجود موقعیت را چک میکند و روی موقعیت ناشناخته کد خروج `2` میدهد.
- به همین ترتیب، اگر یک کارت دو بار پشت سر هم `check` شود و هر دو بار پذیرفته شود، تعداد افراد داخل **دو واحد** بالا میرود. سامانه حضور تکتک کارتها را ردیابی نمیکند و فقط یک شمارندهٔ عددی برای هر موقعیت دارد.
- **دستور** `occupancy` بدون آرگومان همهٔ موقعیتها را مرتب شده بر اساس نام چاپ میکند و روی موقعیت ناشناخته کد خروج `2` میدهد.
- موقعیت تازهساخته باید **بلافاصله** در `occupancy` با مقدار `0` دیده شود، حتی وقتی هنوز هیچکس داخلش نرفته. سادهترین راه این است که همان `add-zone` علاوه بر ردیف موقعیت، یک ردیف حضور با مقدار صفر هم بسازد؛ وگرنه باید موقع خواندن، نبودِ ردیف را صفر حساب کنید.
- دستور `access-report` وقتی هیچ `check`ای انجام نشده، با کد خروج `0` و بدون هیچ خط خروجی تمام میشود.
| 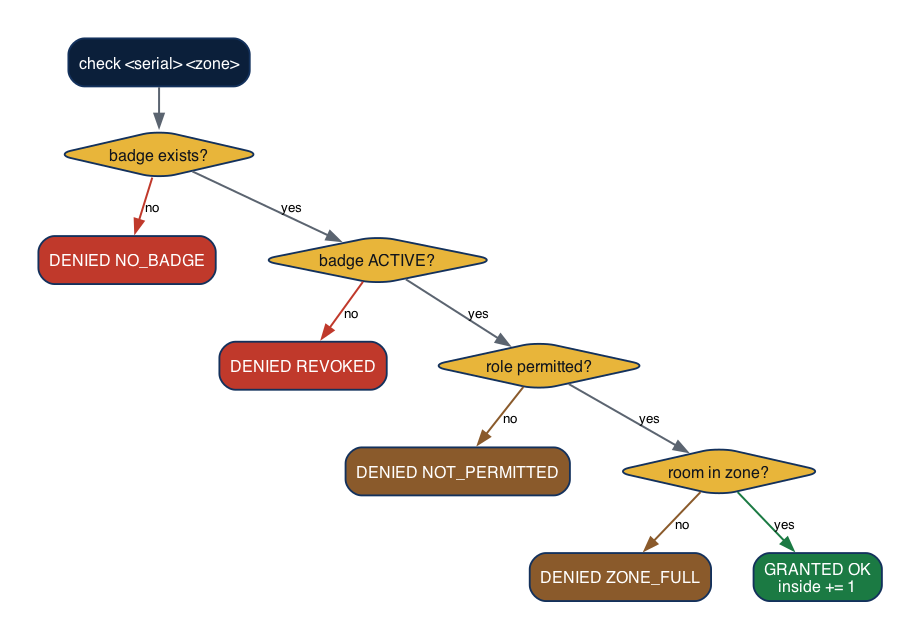 |
| :-: |
| منطق `check`: بررسیِ وجود کارت، وضعیت کارت، مجوز نقش و ظرفیت موقعیت و در پایان یکی از پنج نتیجه. |
<details class="red">
<summary>**هشدار: پذیرش همزمان و رقابت روی ظرفیت**</summary>
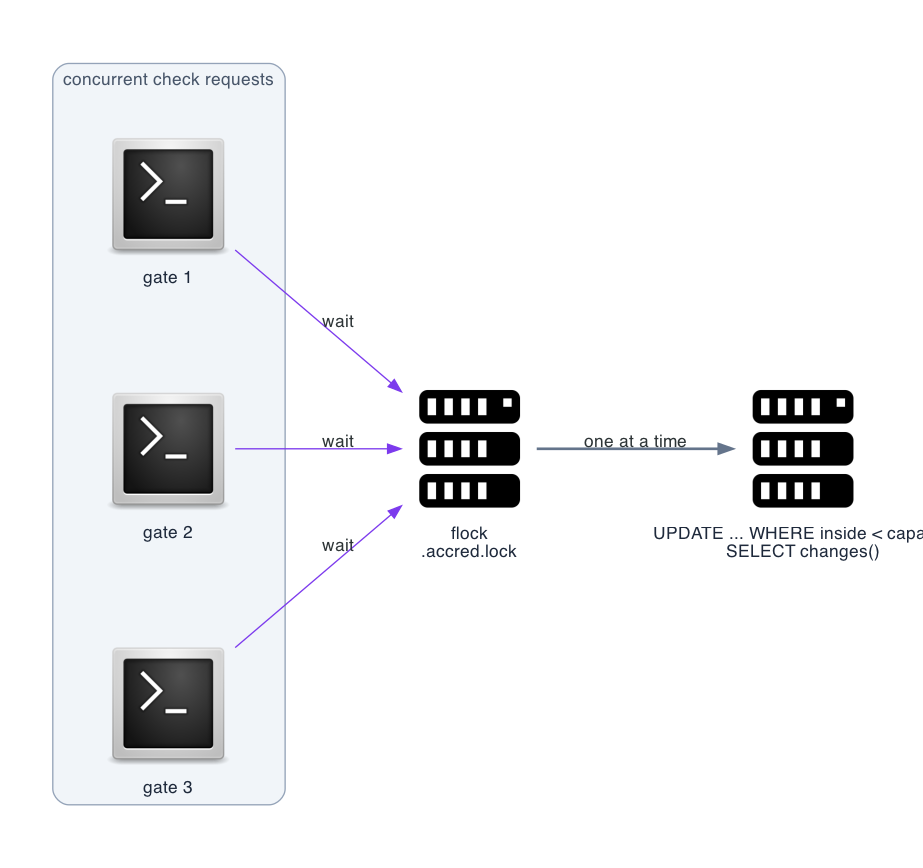
سیستم داوری چند دستور `check` را **همزمان و روی یک موقعیت** اجرا میکند. اگر «خواندن تعداد فعلی»، «مقایسه با ظرفیت» و «اضافه کردن یک واحد» را سه دستور جدا انجام دهید، دو پروسهٔ همزمان میتوانند هر دو ببینند که موقعیت جا دارد و هر دو وارد شوند و تعداد افراد داخل از ظرفیت رد شود.
برای درست کار کردن باید این سه گام یک **عملیات اتمیک** باشند. سادهترین راه یک `UPDATE` شرطی است که فقط وقتی تعداد فعلی کمتر از ظرفیت باشد یکی اضافه میکند و بعد با `changes()` میفهمید ردیفی تغییر کرد یا نه.
لایهٔ دادهٔ شما باید هر دسترسی را با `flock` سریالی کند، اما اتمیک بودنِ منطقِ پذیرش بر عهدهٔ خودتان است. دو تست این بخش، پانزده و دوازده `check` همزمان میفرستند و انتظار دارند نه هیچ ورودی گم شود و نه تعداد افراد از ظرفیت رد شود.
</details>
| 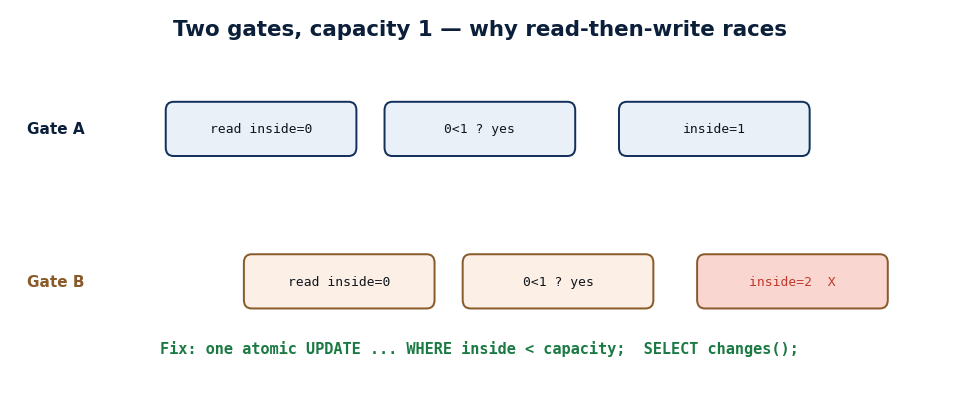 |
| :-: |
| چرا خواندن و نوشتنِ جدا خطرناک است: دو گیت همزمان هر دو ظرفیت خالی میبینند و تعداد افراد از ظرفیت رد میشود؛ راهحل، یک پذیرشِ اتمیک است. |
## **داده، یکپارچگی و سرور**
| **دستور** | **عملیات** |
| --: | --: |
| `export-json` و `dump-json` | چاپ کل دیتابیس بهصورت *JSON* مرتب و قطعی. خروجی این دو باید **کاملاً یکسان** باشد |
| `export-csv` | چاپ افراد بهصورت *CSV* با سطر هدر |
| `import-json <file>` | بارگذاری افراد، موقعیتها، مجوزها و کارتها از یک فایل *JSON* |
| `validate` | بررسی یکپارچگی و چاپ خطاهای مرتب شده |
| `integrity-check` | هش *SHA-256* مستقل از ترتیب از همان چهار موجودیتی که `export-json` میدهد |
| `backup <file>` و `restore <file>` | پشتیبانگیری و بازگرداندن کامل دیتابیس |
| `audit-log [n]` و `statistics` | گزارش تغییرات ثبتشده و آمار کلی |
| `serve <port> [--once]` | سرور *TCP* فقطخواندنی |
قالب دقیق خروجی هرکدام:
**`export-json`:** یک سند *JSON* با دقیقاً چهار کلید سطح بالا `badges`، `people`، `permissions` و `zones`. آرایهٔ `people` باید **مرتب شده بر اساس نام** باشد و هر عضوش کلید `name` داشته باشد.
**`export-csv`:** خط اول دقیقاً `name,role,org` و بعد یک خط برای هر فرد، مثلاً `Sara,PRESS,IRIB`.
**`import-json <file>`:** باید طوری داده را بازسازی کند که اگر خروجی `export-json` یک دیتابیس را در دیتابیس خالیِ دیگری وارد کنید، `integrity-check` هر دو **عدد یکسانی** بدهد.
+ **این شرط دامنهٔ `integrity-check` را تعیین میکند.** هش باید فقط روی همان چهار موجودیتِ `badges`، `people`، `permissions` و `zones` حساب شود؛ یعنی همانهایی که از `export-json` بیرون میآیند و `import-json` بازسازیشان میکند. اگر لاگ تغییرات یا شمارش حضور یا آمار پذیرش را هم داخل هش بیاورید، دیتابیس تازهواردشده هرگز به همان عدد نمیرسد، چون آن دادهها در سند *JSON* نیستند. مثل سؤالهای دیگر، ترتیبناپذیری را با `LC_ALL=C sort` روی سطرها قبل از `sha256sum` بگیرید.
**`validate`:** روی دیتابیس سالم فقط واژهٔ `OK` را چاپ میکند و کد خروج `0` میدهد. اگر مشکلی پیدا کند، کد خروج `3` میدهد و برای هر مشکل یک خط چاپ میکند:
```text output terminal
BADGE <serial> UNKNOWN_PERSON
PERM <role> <zone> UNKNOWN_ZONE
ZONE <zone> OVER_CAPACITY <inside>/<capacity>
```
> خط اول برای کارتی است که به فردی اشاره میکند که وجود ندارد، خط دوم برای مجوزی که به موقعیت ناشناخته اشاره میکند و خط سوم برای موقعیتی که تعداد افراد داخلش از ظرفیتش رد کرده است. سیستم داوری این حالتها را با نوشتن مستقیم در دیتابیس شما میسازد، برای همین بود که نام جدولها و ستونها در بخش اسکیما اجباری شد.
**`integrity-check`:** دقیقاً یک خط به شکل `INTEGRITY <hex>` که در آن `<hex>` یک هش *SHA-256* شصتوچهار کاراکتری با حروف کوچک است.
+ **قالب سریالایز دلخواه خودتان است** و با هیچ مقدار ثابتی مقایسه نمیشود. فقط این سه رفتار سنجیده میشود: اجرای دوباره روی دادهٔ عوضنشده همان هش را بدهد، اضافه شدن حتی یک فرد هش را عوض کند و وارد کردن خروجی `export-json` در یک دیتابیس خالی همان هش را بازتولید کند. برای همین کافی است سریالایز شما مرتب و قطعی باشد و به شناسههای داخلی *SQLite* مثل `rowid` وابسته نباشد.
**`backup <file>` و `restore <file>`:** بعد از `backup`، تغییر دادن داده و بعد `restore`، مقدار `integrity-check` باید به همان عدد قبل از `backup` برگردد. دستور `restore` روی فایلی که وجود ندارد کد خروج `2` میدهد.
**`audit-log [n]`:** هر تغییر ثبتشده در یک خط، که خط با **نام همان دستور** شروع میشود، مثلاً `add-person ...` یا `add-zone ...`.
**`statistics`:** باید دستکم این خطها را داشته باشد:
```text output terminal
people=3
zones=2
badges=3 active=3
access granted=1 denied=1
```
> هر خط یک شمارش از وضعیت فعلی است: تعداد افراد، تعداد موقعیتها، تعداد کل کارتها بههمراه تعداد کارتهای فعال و تعداد تصمیمهای پذیرش و رد. سیستم داوری وجود این خطها را در خروجی میسنجد، پس دقیقاً همین قالب را رعایت کنید. میتوانید خطهای بیشتری هم چاپ کنید.
**`serve <port> [--once]` و `__handle`:** سرور فقط به زیرمجموعهای از دستورهای فقطخواندنی مانند `ping`، `occupancy`، `permissions`، `who-can-enter` و `list-*` پاسخ میدهد و هر دستور تغییردهنده را با یک خط که با `ERROR` شروع میشود رد میکند. دستور `ping` باید `PONG` برگرداند.
+ **توجه:** علاوه بر `serve`، ابزار شما باید یک زیردستور داخلی به نام `__handle` هم داشته باشد. این زیردستور **یک خط درخواست را از ورودی استاندارد میخواند**، همان منطق فقطخواندنی را اجرا میکند و پاسخ را در خروجی استاندارد چاپ میکند. سیستم داوری هم `__handle` را مستقیم صدا میزند و هم با `serve <port> --once` یک اتصال *TCP* واقعی برقرار میکند و انتظار پاسخ `PONG` دارد.
| 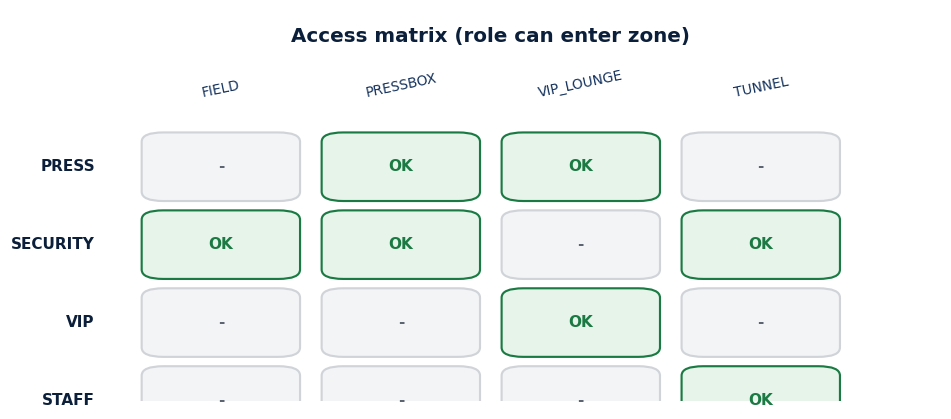 |
| :-: |
| ماتریس دسترسیِ نقشها به موقعیتها و اینکه چگونه هر تلاش ورود در برابر آن سنجیده میشود. |
# **نمونه**
فرض کنید سامانه را اینطور راهاندازی کردهایم و بعد چند تلاش ورود را میسنجیم:
```text session terminal
$ ./solution.sh add-person Sara PRESS IRIB
PERSON Sara PRESS IRIB
$ ./solution.sh add-zone PRESSBOX 3
ZONE PRESSBOX 3
$ ./solution.sh grant PRESS PRESSBOX
GRANT PRESS PRESSBOX
$ ./solution.sh issue Sara B-1
BADGE B-1 Sara ACTIVE
$ ./solution.sh check B-1 PRESSBOX
GRANTED B-1 PRESSBOX OK
$ ./solution.sh occupancy PRESSBOX
PRESSBOX 1/3
```
> اول فرد `Sara` با نقش `PRESS` ثبت و موقعیت `PRESSBOX` با ظرفیت `3` تعریف میشود، بعد نقش `PRESS` برای این موقعیت مجاز و یک کارت `B-1` برای `Sara` صادر میشود. وقتی کارت `B-1` برای ورود به `PRESSBOX` سنجیده میشود، چون کارت فعال است و نقشش مجاز است و موقعیت جا دارد، نتیجه `GRANTED B-1 PRESSBOX OK` میشود و تعداد افراد داخل به `1/3` میرسد. اگر همین کارت را برای موقعیتی میسنجیدیم که نقش `PRESS` در آن مجاز نبود، نتیجه `DENIED B-1 <zone> NOT_PERMITTED` بود و عدد حضور تغییری نمیکرد.
حالا فرض کنید کارت را باطل کنیم و دوباره بسنجیم:
```text session terminal
$ ./solution.sh revoke B-1
BADGE B-1 Sara REVOKED
$ ./solution.sh check B-1 PRESSBOX
DENIED B-1 PRESSBOX REVOKED
$ ./solution.sh integrity-check
INTEGRITY 3f2a9c1b8e47d05a6c2f1b93ae70d4c8f5619b2ad3e08c74195fb6237ce0a8d1
```
> بعد از باطل شدن، وضعیت کارت `REVOKED` میشود و تلاش بعدی ورود با دلیل `REVOKED` رد میشود، بدون اینکه کد خروج خطا بدهد. دستور `integrity-check` هم یک هش *SHA-256* از وضعیت میسازد که تا وقتی داده عوض نشود ثابت میماند و اگر حتی یک فرد یا کارت اضافه شود عوض میشود. عددی که اینجا میبینید فقط یک نمونهٔ شصتوچهار کاراکتری است و قرار نیست با خروجی شما یکی باشد؛ آنچه سنجیده میشود قالب خط و **پایداری** همان عدد است، نه مقدارش.
|  |
| :-: |
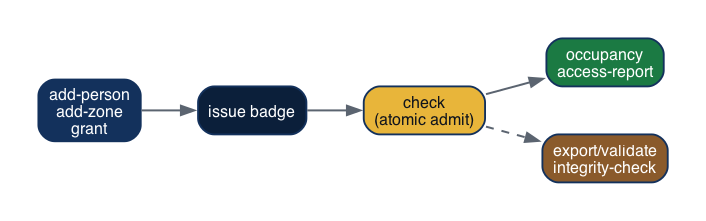
| مسیر داده: ثبت فرد و موقعیت، صدور کارت، سنجش ورود در برابر ماتریس دسترسی و ظرفیت و بهروزرسانی تعداد افراد داخل. |
|  |
| :-: |
| همهٔ پردازهها روی یک قفل مشترک هماهنگ میشوند و ظرفیت هرگز از حد رد نمیشود. |
+ **دو بخش از این جدول بهصورت «همه یا هیچ» نمره میگیرند** و در آنها امتیاز جزئی وجود ندارد: پذیرش همزمان با `flock` و اجرای سناریوی کامل. یعنی اگر از دو تست همزمانی یکی رد شود، هر شش امتیاز آن بخش میرود. بقیهٔ بخشها معمولیاند و بهازای هر تست موفق امتیاز میدهند.
## **نقشهٔ امتیازها**
از این جدول برای انتخاب مسیر خودتان استفاده کنید. هر ردیف مستقل نمره میگیرد:
| **بخش** | **سابتسک** | **درصد** |
| --: | --: | :-: |
| ساختار و راهنما | `help`، کد خروج دستور ناشناخته، اجرای تمیز روی دیتابیس خالی | ۲ |
| افراد | `add-person`، `list-people` | ۵ |
| موقعیتها | `add-zone`، `list-zones` | ۴ |
| ماتریس دسترسی | `grant`، `revoke-perm`، `permissions` | ۶ |
| کارتها | `issue`، `revoke`، `list-badges` | ۶ |
| پذیرش موفق | `check` وقتی مجاز است | ۵ |
| رد کارت ناشناخته یا باطل | `check` با `NO_BADGE` و `REVOKED` | ۶ |
| رد نقش غیرمجاز | `check` با `NOT_PERMITTED` | ۵ |
| رد بهخاطر پر بودن موقعیت | `check` با `ZONE_FULL` | ۶ |
| خروج از موقعیت | `leave` | ۴ |
| گزارش حضور | `occupancy` | ۴ |
| فهرست مجازها | `who-can-enter` | ۴ |
| گزارش پذیرش و رد | `access-report` | ۴ |
| پذیرش همزمان | درست ماندن `check` زیر اجرای موازی | ۶ |
| ورودی و خروجی داده | `export-json`، `dump-json`، `export-csv`، `import-json` | ۵ |
| بررسی یکپارچگی | `validate` | ۵ |
| هش یکپارچگی | `integrity-check` | ۴ |
| پشتیبان و بازیابی | `backup`، `restore` | ۴ |
| لاگ و آمار | `audit-log`، `statistics` | ۵ |
| تطبیق با مدل مرجع | یک سناریوی کامل که با مدل مستقل سنجیده میشود | ۵ |
| سرور فقطخواندنی | `serve` و `__handle` | ۵ |
> اگر وقتتان محدود است، از بالای جدول شروع کنید. ردیفهای «افراد» تا «کارتها» با هم ۲۱ درصد دارند و هیچکدام به *SQLite* پیچیده یا پایتون نیاز ندارند. بعد سراغ چهار ردیف `check` بروید که روی هم ۲۲ درصد امتیازند و هستهٔ فنی سؤالند. ردیفهای داده و سرور را برای آخر بگذارید: امتیازشان بخش خوبی از سوال است ولی هرکدام یک قطعهٔ پایتونی جدا لازم دارند.
# **آنچه باید آپلود کنید**
کل درخت پروژه را بسازید و آپلود کنید. لازم نیست همهٔ ماژولها را پیاده کنید؛ هر بخش امتیاز خودش را جداگانه میگیرد.
فایلهایی که سیستم داوری میپذیرد:
- `solution.sh`
- `lib/*.sh`
- `lib/*.py`
- `lib/*.sql`
- `lib/shims/*`
+ **توجه:** مسیر پوشهٔ داده را از **متغیر محیطی** `ACCRED_DATA_DIR` بخوانید و فایل دیتابیس را **دقیقاً** `accred.db` نام بگذارید.
+ **توجه:** چون `sqlite3` و `jq` و `nc` روی داور نصب نیستند، کار با *SQLite* و *JSON* و *TCP* را با `python3` انجام دهید.
+ **توجه:** برای هش `integrity-check` از `printf '%s'` استفاده کنید تا خط جدید اضافهای وارد ورودی هش نشود و سریالایز را مرتب و قطعی بسازید.
+ **توجه:** منطق پذیرش در `check` باید زیر اجرای همزمان چند گیت درست بماند و تعداد افراد داخل هرگز از ظرفیت رد نشود.
+ **توجه:** اگر فایلهای `lib/shims/*` را اجرایی نمیفرستید، در `solution.sh` خودتان با `chmod +x` قابل اجرایشان کنید.
جام خط فرمانیان!
| پروژهٔ اولیهٔ این سوال را میتوانید از [این لینک](/contest/assignments/103145/download_problem_initial_project/356753/) دانلود کنید. |
| :-: |
تابلوی نتایج زندهٔ **جام جهانی فناوری پردیس ۲۰۲۶** روی سایت رویداد، زیر لود درخواستهای پیاپی هواداران است. سرویس *API* که نتایج را میدهد کوچک است و این حجم درخواست را تاب نمیآورد! سلیب بهجای بزرگکردن خود سرویس، قرار است جلوی آن یک **گیتوی** قرار دهد که خودش کش کند، درخواستهای نوشتن را احراز هویت کند، نرخ هر کلاینت را محدود کند و آمار کار خودش را هم نمایش دهد. این گیتوی روی *OpenResty* ساخته میشود که *nginx* را با زبان **Lua** ترکیب میکند. سلیب از شما میخواهد این استک سهسرویسی را بسازید و منطق گیتوی را در **چند ماژول مستقل Lua** بنویسید.
# **پروژهٔ اولیه**
برای دانلود **پروژهٔ اولیه** روی [این لینک](/contest/assignments/103145/download_problem_initial_project/356753/) کلیک کنید. کد سرویس *API* در پوشهٔ `api/` **از قبل نوشته شده** و نیازی به تغییرش ندارید. شما باید `api/Dockerfile`، `docker-compose.yml`، `edge/nginx.conf` و ماژولهای `edge/lua/` را بنویسید.
<details class="grey">
<summary>**نکته: ساختار پروژه و اینکه چه چیزی را باید بسازید**</summary>
```
.
├── api/
│ ├── <mark class="blue" title="از قبل پیادهسازی شده">main.go</mark>
│ ├── <mark class="blue" title="از قبل پیادهسازی شده">go.mod</mark>
│ └── <mark class="green" title="باید پیادهسازی شود">Dockerfile</mark>
├── edge/
│ ├── <mark class="green" title="باید پیادهسازی شود">nginx.conf</mark>
│ └── lua/
│ ├── <mark class="green" title="باید پیادهسازی شود">redisc.lua</mark>
│ ├── <mark class="green" title="باید پیادهسازی شود">util.lua</mark>
│ ├── <mark class="green" title="باید پیادهسازی شود">limiter.lua</mark>
│ ├── <mark class="green" title="باید پیادهسازی شود">auth.lua</mark>
│ ├── <mark class="green" title="باید پیادهسازی شود">cache.lua</mark>
│ ├── <mark class="green" title="باید پیادهسازی شود">stats.lua</mark>
│ └── <mark class="green" title="باید پیادهسازی شود">gateway.lua</mark>
└── <mark class="green" title="باید پیادهسازی شود">docker-compose.yml</mark>
```
نام دقیق ماژولها دلخواه شماست، ولی منطق باید واقعاً به **دستکم چهار فایل مستقل `.lua`** شکسته شود. نوشتن همهٔ منطق در یک بلوک بزرگ داخل `nginx.conf` **به هیچ عنوان در سیستم داوری پذیرفته نمیشود.**
</details>
# **جزئیات**
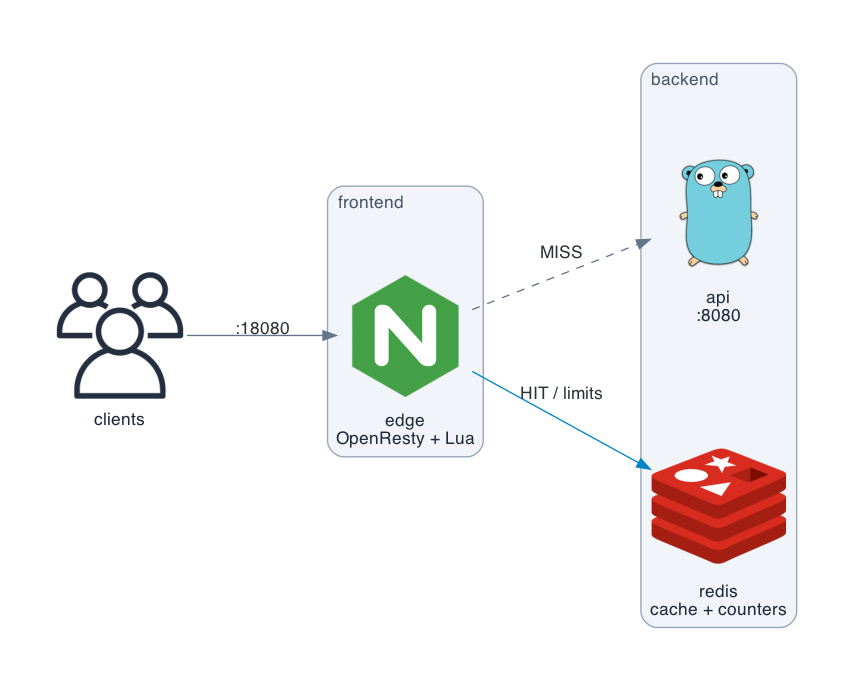
**استک** از سه سرویس تشکیل میشود و فقط **گیتوی** روی میزبان در دسترس قرار میگیرد. سرویس *API* و *Redis* فقط از پشت گیتوی و روی شبکهٔ داخلی در دسترساند.
|  |
| :-: |
| گیتوی *OpenResty* روی هر دو شبکه است، سرویس *API* و *Redis* تنها روی شبکهٔ پشتی؛ فقط گیتوی پورت میزبان دارد. |
## **پیادهسازی فایل `api/Dockerfile`**
سرویس *API* یک برنامهٔ کوچک *Go* است که سه مسیر دارد: `GET /health` که `ok` میدهد، `GET /standings` که ردهبندی را بهصورت *JSON* میدهد و `POST /event` که یک گل را ثبت میکند. هر پاسخ `/standings` یک شمارندهٔ `served_by` دارد که فقط وقتی **واقعاً به سرویس رسیده باشد** یکی بالا میرود. همین شمارنده است که نشان میدهد پاسخ از کش گیتوی آمده یا از خود سرویس.
برای این سرویس یک `Dockerfile` بنویسید که:
- **چندمرحلهای** باشد، یعنی دستکم دو دستور `FROM` داشته باشد.
- مرحلهٔ ساخت از ایمیج `ghcr.io/qregistry/standard/golang:1.17` استفاده کند.
- مرحلهٔ نهایی روی یک ایمیج سبک مثل `ghcr.io/qregistry/standard/alpine:3.15` باشد، نه روی ایمیج بزرگ ساخت قبلی.
- پورت `8080` را `EXPOSE` کند.
- با دستور `USER` کانتینر را با کاربر **غیر روت** اجرا کند.
## **پیادهسازی فایل `docker-compose.yml`**
سه سرویس با این نامهای دقیق تعریف کنید:
| **سرویس** | **ایمیج یا ساخت** | **نکته** |
| --: | --: | --: |
| `api` | با `build` از `./api` ساخته شود | هیچ پورتی روی میزبان منتشر نکند |
| `redis` | `ghcr.io/qregistry/standard/redis:7-alpine` | هیچ پورتی روی میزبان منتشر نکند |
| `edge` | `ghcr.io/qregistry/standard/openresty:1.19.9.1-5-alpine-fat` | تنها سرویسی که پورت منتشر میکند |
- **دو شبکهٔ مجزا** تعریف کنید. سرویس `edge` روی هر دو شبکه است، ولی `api` و `redis` فقط روی شبکهٔ پشتی. یعنی باید شبکهای وجود داشته باشد که `edge` روی آن است و `api` روی آن نیست.
- سرویس `edge` باید پورت میزبان **`18080`** را منتشر کند.
- سرویس `edge` باید هم فایل `edge/nginx.conf` و هم **پوشهٔ** `edge/lua` را داخل کانتینر مانت کند، آن هم روی این مسیرهای دقیق:
```yaml docker-compose.yml docker
volumes:
- ./edge/nginx.conf:/usr/local/openresty/nginx/conf/nginx.conf:ro
- ./edge/lua:/etc/edge/lua:ro
```
> مسیر `/usr/local/openresty/nginx/conf/nginx.conf` همان جایی است که ایمیج *OpenResty* کانفیگ خودش را از آن میخواند. اگر روی `/etc/nginx/nginx.conf` مانت کنید، *OpenResty* کانفیگ پیشفرض خودش را بالا میآورد، سرویس ظاهراً سالم است ولی هیچکدام از رفتارهای خواستهشده کار نمیکند. مسیر `/etc/edge/lua` هم باید با چیزی که در `lua_package_path` مینویسید یکی باشد.
- سرویس `edge` باید این متغیرهای محیطی را داشته باشد: `API_KEY` با مقدار `pardis-secret-2026`، `RATE_LIMIT` و `WRITE_LIMIT`.
## **پیادهسازی فایل `edge/nginx.conf`**
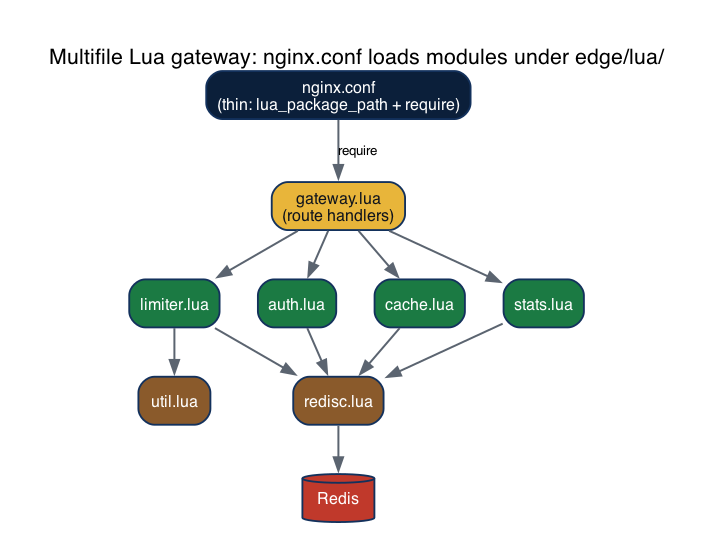
این فایل باید **کوتاه و ساده** بماند و فقط مسیرها را به ماژولهای *Lua* وصل کند:
- با دستور `lua_package_path` مسیر ماژولها را معرفی کند، یعنی همان مسیری که پوشهٔ `edge/lua` را در آن مانت کردهاید.
- در هر مسیر، منطق را با `require(...)` از ماژولها صدا بزند، نه اینکه درجا بنویسد.
- با `proxy_pass` درخواستها را به سرویس `api` بفرستد.
+ **دربارهٔ معماری:** نوشتن منطق در *Lua* و استفاده از `proxy_pass` با هم تناقضی ندارند. الگوی رایج در *OpenResty* این است که یک مسیر **داخلی** با `proxy_pass` به سرویس *API* تعریف کنید و ماژول *Lua* با `ngx.location.capture` آن مسیر داخلی را صدا بزند. اینطوری هم منطق در *Lua* میماند و هم خود *nginx* کار پروکسی را انجام میدهد. روش دیگری هم انتخاب کنید مشکلی نیست؛ فقط رفتار نهایی سنجیده میشود.
## **پیادهسازی رفتار گیتوی**
|  |
| :-: |
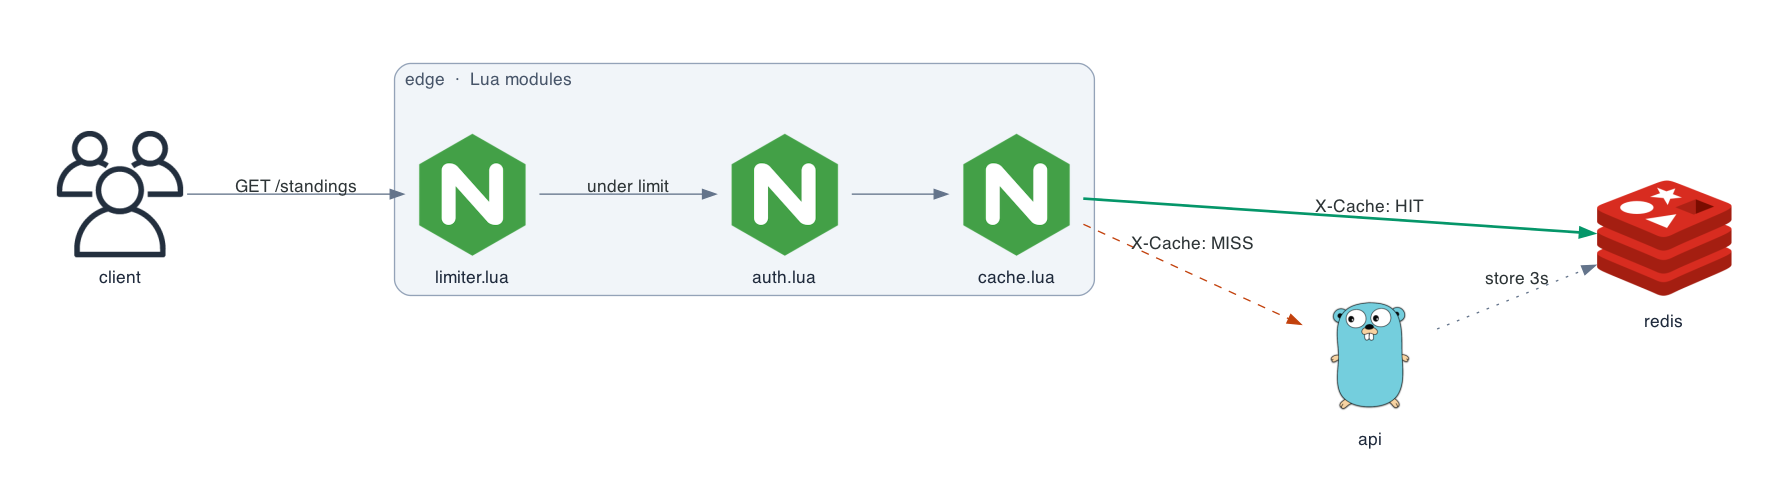
| درخواست اول به سرویس میرسد و درخواست بعدی از کش پاسخ میگیرد. |
### **پیادهسازی کش کوتاهمدت و پاک کردن آن**
- **کل بدنهٔ پاسخ** `GET /standings` را همانطور که از سرویس *API* آمده، به مدت **۳ ثانیه** روی *Redis* نگه دارید. فقط همین یک مسیر کش میشود و یک کلید ثابت دارد؛ اسم کلید دلخواه شماست.
- روی هر پاسخ `GET /standings` هدر `X-Cache` بگذارید که مقدارش **دقیقاً** `HIT` یا `MISS` باشد.
- تا وقتی پاسخ در کش است، `served_by` نباید عوض شود، چون اصلاً به سرویس نمیرسیم.
- هر **نوشتن موفق** روی `POST /event` باید کش ردهبندی را پاک کند تا خواندن بعدی `MISS` شود و دادهٔ تازه را از سرویس بگیرد.
- مسیر مدیریتی `POST /admin/flush` هم کش را دستی پاک میکند و با کلید درست باید `200` برگرداند.
### **پیادهسازی احراز هویت با کلید**
+ **ترتیب مهم است:** روی مسیرهای نوشتن، **اول احراز هویت** انجام میشود و **بعد** محدودیت نرخ. یعنی یک درخواست نوشتن بدون کلید درست، همیشه `401` میگیرد حتی اگر شمارندهٔ نوشتن آن کلاینت پر شده باشد. روی مسیرهای خواندن اصلاً احراز هویتی در کار نیست و فقط محدودیت نرخ اعمال میشود.
- مسیرهای `POST /event` و `POST /admin/flush` محافظتشدهاند. گیتوی هدر `X-API-Key` را با مقدار متغیر `API_KEY` **دقیقاً و حساس به حروف** مقایسه میکند.
- اگر این هدر نبود یا مقدارش اشتباه بود، همان گیتوی با کد **`401`** رد میکند و درخواست اصلاً به سرویس نمیرسد.
- خواندن ردهبندی عمومی است و کلید نمیخواهد.
### **پیادهسازی محدودیت نرخ با دو شمارندهٔ جدا**
**شناسایی کلاینت:** اگر هدر `X-Forwarded-For` وجود داشت، **اولین** *IP* آن استفاده میشود و اگر نبود، نشانی مستقیم کلاینت. اولین ورودی این هدر یعنی کلاینت اصلی و چون اینجا میخواهیم نرخ را برای خودِ کاربر نهایی بشماریم نه برای پروکسی میانی، همان ملاک است. در تستهای داوری این هدر همیشه فقط یک *IP* دارد.
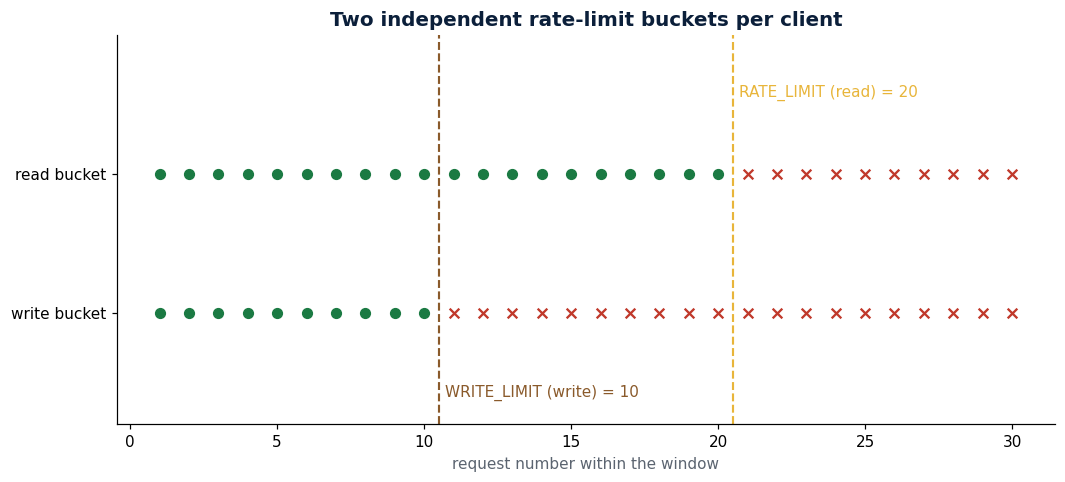
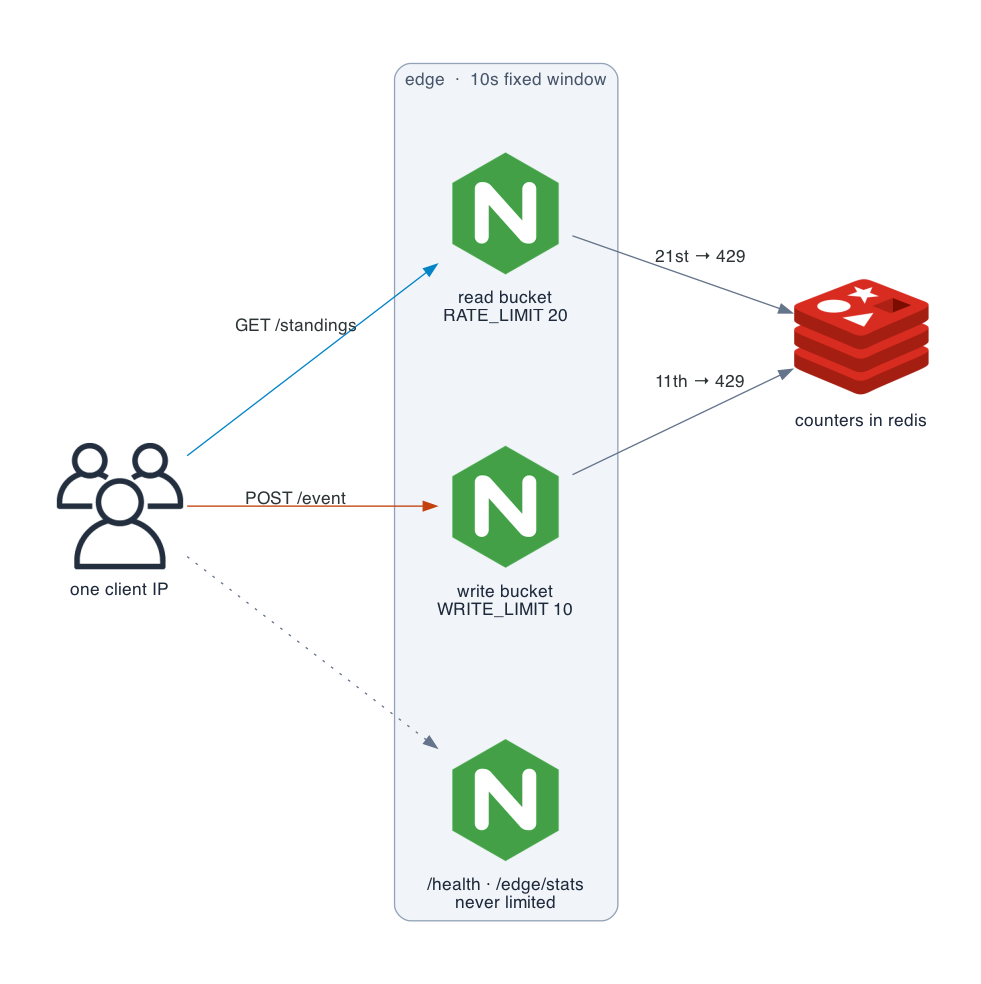
خواندن و نوشتن **دو شمارندهٔ کاملاً جدا** دارند و هرکدام یک **پنجرهٔ ثابت ده ثانیهای** دارند:
| **شمارنده** | **سقف از کدام متغیر** | **مقدار مورد انتظار** |
| --: | --: | :-: |
| **خواندن** | `RATE_LIMIT` | `20` |
| **نوشتن** | `WRITE_LIMIT` | `10` |
+ **توجه:** این عددها دلخواه نیستند. سیستمداوری انتظار دارد دستکم ۱۵ خواندن پیاپی قبول شود ولی ۳۵ خواندن به `429` برسد و ۲۰ نوشتن پیاپی به `429` برسد در حالی که بعد از ۳۵ خواندن هنوز یک نوشتن قبول شود. مقدارهای بالا این شرطها را برآورده میکنند.
قاعدهٔ دقیق شمارش این است:
- برای هر کلاینت و هر شمارنده یک کلید جدا نگه دارید و در هر درخواست یکی به آن اضافه کنید.
- **فقط در اولین افزایش**، برای آن کلید یک انقضای ده ثانیهای بگذارید. اگر در هر درخواست انقضا را دوباره ست کنید، پنجره مدام تمدید میشود و دیگر پنجرهٔ ثابت ندارید.
- اگر مقدار شمارنده **از سقف بیشتر شد** پاسخ `429` بدهید. یعنی با سقف `20`، بیست درخواست اول `200` میگیرند و درخواست بیستویکم `429`.
- بعد از پایان پنجره، کلید منقضی میشود و شمارش از صفر شروع میشود.
قواعد دیگر:
- پر شدن شمارندهٔ خواندن نباید نوشتن را ببندد و برعکس. بعد از ۳۵ خواندنِ پیاپی، یک نوشتن از همان کلاینت باید همچنان `200` بگیرد.
- مسیرهای `/health` و `/edge/stats` **هرگز** محدود نمیشوند. دلیلش عملی است: سیستم داوری اول با یک سیل درخواست شمارنده را پر میکند و بعد از **همان کلاینت** آمار را میخواند؛ اگر `/edge/stats` هم محدود شود، بهجای شمارندهها `429` میگیرد.
- مسیر `/admin/flush` در **دستهٔ نوشتن** حساب میشود، چون یک عمل تغییردهنده است.
- شمارندههای `/edge/stats` **تجمعی**اند، یعنی از ابتدای بالا آمدن گیتوی جمع میشوند و با پایان پنجرهٔ نرخ صفر نمیشوند. هر `401` هم در `auth_failures` شمرده میشود، چه روی نوشتن باشد چه روی `/admin/flush`.
- اگر خود سرویس *API* پاسخی با وضعیت خطا برگرداند، گیتوی باید **همان وضعیت را عیناً عبور دهد** و آن را به `502` تبدیل نکند. مثلاً بدنهٔ نامعتبر روی `/event` باید همان `400` سرویس را به کلاینت برساند؛ `502` فقط وقتی معنا دارد که گیتوی اصلاً نتواند به سرویس وصل شود.
- فقط `429`هایی که **خودِ گیتوی** تولید میکند شمارندهٔ `rate_limited` را بالا میبرند.
|  |
| :-: |
| شمارندهٔ خواندن و شمارندهٔ نوشتن جدا هستند؛ پر شدن یکی دیگری را نمیبندد و مسیر سلامت هرگز محدود نمیشود. |
### **پیادهسازی شناسهٔ درخواست و متریک**
- هر پاسخ باید هدر `X-Request-Id` داشته باشد و مقدار آن در هر درخواست **یکتا** باشد.
- مسیر `GET /edge/stats` باید یک *JSON* با این چهار کلید بدهد که خود گیتوی روی *Redis* نگه میدارد:
```json output json
{"cache_hits":12,"cache_misses":5,"rate_limited":3,"auth_failures":2}
```
> هر `HIT` باید `cache_hits` را یکی بالا ببرد و هر `MISS` باید `cache_misses` را. هر پاسخ `429` باید `rate_limited` را زیاد کند و هر رد شدن احراز هویت باید `auth_failures` را. سیستم داوری این شمارندهها را قبل و بعد از هر رویداد میخواند و انتظار دارد عددشان بالا رفته باشد، پس هر چهار کلید باید واقعاً بهروز شوند.
<details class="pink">
<summary>**راهنمایی: شکستن منطق به ماژولهای Lua و صدا زدن آنها**</summary>
در `nginx.conf` مسیر ماژولها را معرفی کنید و در هر مسیر، بهجای نوشتن منطق درجا، آن را از ماژول صدا بزنید:
```nginx edge/nginx.conf nginx
env API_KEY;
env RATE_LIMIT;
env WRITE_LIMIT;
http {
resolver 127.0.0.11 ipv6=off;
lua_package_path "/etc/edge/lua/?.lua;;";
server {
listen 80;
location = /standings {
content_by_lua_block { require("gateway").standings() }
}
}
}
```
> دستور `env` باعث میشود متغیرهای محیطی داخل *Lua* با `os.getenv` دیده شوند؛ بدون آن مقدارشان `nil` میشود. دستور `resolver 127.0.0.11` هم *DNS* داخلی داکر را معرفی میکند تا نام `redis` از داخل *Lua* و از طریق کوسوکت پیدا شود. مسیر `/etc/edge/lua` همان جایی است که پوشهٔ `edge/lua` را مانت کردهاید، پس اگر جای دیگری مانت کردید این مسیر را هم عوض کنید.
هر ماژول یک جدول برمیگرداند و یک مسئولیت دارد:
- ماژول اتصال به *Redis* با `resty.redis` و `red:connect`.
- ماژول محدودیت نرخ با `red:incr` روی یک کلید مخصوص کلاینت و `red:expire` روی همان کلید برای بازهٔ ۱۰ ثانیهای.
- ماژول کش با `red:setex` برای ذخیره و `red:del` برای پاک کردن.
- ماژول اصلی که اینها را به هندلرهای مسیر میچسباند.
</details>
|  |
| :-: |
| فایل `nginx.conf` کوتاه میماند و منطق را با `require` از ماژولهای مستقل `edge/lua/` صدا میزند؛ هر ماژول یک مسئولیت دارد. |
|  |
| :-: |
| خواندن و نوشتن سقف جداگانه دارند و دو مسیر معاف هرگز محدود نمیشوند. |
# **نمونه**
بعد از بالا آوردن استک با `docker compose up`، دو خواندن پیاپی ردهبندی، بار دوم از کش پاسخ میگیرد و بعد از یک نوشتن، کش پاک میشود:
```text terminal terminal
$ curl -s -D- http://localhost:18080/standings | grep -iE 'X-Cache|served_by'
X-Cache: MISS
{"served_by":7,"standings":[...]}
$ curl -s -D- http://localhost:18080/standings | grep -i X-Cache
X-Cache: HIT
$ curl -s -X POST -H 'X-API-Key: pardis-secret-2026' -d '{"team":"IRAN"}' http://localhost:18080/event
recorded
$ curl -s -D- http://localhost:18080/standings | grep -i X-Cache
X-Cache: MISS
```
> خواندن اول در کش نیست، پس گیتوی از سرویس میگیرد و `X-Cache: MISS` میگذارد. خواندن دوم چون داخل بازهٔ سه ثانیهای است همان پاسخ را با `X-Cache: HIT` برمیگرداند و چون سرویس اصلاً صدا زده نشده `served_by` ثابت میماند. بعد از نوشتن موفق، گیتوی کش را پاک میکند، بنابراین خواندن بعدی دوباره `MISS` میشود و دادهٔ تازه را نشان میدهد.
نوشتن بدون کلید و مسیر مدیریتی بدون کلید رد میشوند:
```text terminal terminal
$ curl -s -o /dev/null -w '%{http_code}\n' -X POST -d '{"team":"IRAN"}' http://localhost:18080/event
401
$ curl -s -o /dev/null -w '%{http_code}\n' -X POST http://localhost:18080/admin/flush
401
$ curl -s http://localhost:18080/edge/stats
{"cache_hits":12,"cache_misses":5,"rate_limited":3,"auth_failures":2}
```
> نوشتن و پاک کردن کش بدون هدر `X-API-Key` را همان گیتوی با `401` رد میکند و درخواست به سرویس نمیرسد. اگر یک کلاینت خیلی سریع درخواست بفرستد، بعد از عبور از سقف شمارندهٔ مربوطه پاسخ `429` میگیرد. مسیر `/edge/stats` هم شمارندههایی را که خود گیتوی روی *Redis* نگه داشته گزارش میدهد.
+ **دو بخش بهصورت صفر و یکی نمره میگیرند:** بودن فایلهای لازم (۳ درصد از امتیاز) و بالا آمدن و جواب دادن استک (۶ درصد از امتیاز). یعنی اگر `docker compose up` استک شما را کامل بالا نیاورد، این ۹ درصد کامل از دست میرود و چون بیشتر تستهای دیگر هم به استکِ در حال اجرا نیاز دارند، عملاً باید اول این را درست کنید.
## **سابتسکها**
| **سابتسک** | **درصد** |
| --: | :-: |
| بودن فایلهای لازم | ۳ |
| `Dockerfile` چندمرحلهای و سختشدهٔ *API* | ۸ |
| سرویسها و ایمیجهای `docker-compose.yml` | ۷ |
| جداسازی شبکهها و انتشار درست لبه | ۸ |
| ساختار چندفایلی دروازهٔ *Lua* | ۱۲ |
| بالا آمدن و جواب دادن استک | ۶ |
| افزوده شدن شناسهٔ درخواست به پاسخها | ۴ |
| کش کوتاهمدت در دو حالت اصابت و خطا | ۹ |
| باطل شدن کش هنگام نوشتن | ۸ |
| مسیر محافظتشدهٔ پاک کردن کش | ۷ |
| احراز هویت با کلید *API* روی نوشتنها | ۸ |
| محدودیت نرخ خواندن | ۷ |
| دستهٔ جداگانهٔ محدودیت نرخ نوشتن | ۶ |
| مسیر آمار متریکهای لبه | ۷ |
> دو ردیف «بودن فایلهای لازم» و «بالا آمدن استک» همان دو بخش «صفر و یکی»اند. بقیه بهازای هر تست موفق امتیاز میدهند، پس اگر مثلاً کش را پیاده کنید ولی به محدودیت نرخ نرسید، **نمرهٔ کش را کامل میگیرید.**
# **آنچه باید آپلود کنید**
کل درخت پروژه را *ZIP* کنید و بفرستید. سیستم داوری این فایلها را میپذیرد:
- `docker-compose.yml`
- `api/Dockerfile`
- `edge/nginx.conf`
- `edge/lua/*.lua`
- `api/main.go` و `api/go.mod` که از قبل آمادهاند **و نباید تغییرشان دهید!**
+ **توجه:** منطق گیتوی باید واقعاً به **دستکم چهار ماژول مستقل `.lua`** در `edge/lua/` شکسته شود. سیستم داوری تعداد فایلها و صدا زده شدنشان با `require` را بررسی میکند.
+ **توجه:** سیستم داوری استک را با `docker compose up` بالا میآورد و رفتار گیتوی را زنده از پورت `18080` میسنجد. همهٔ ایمیجها باید از `ghcr.io/qregistry/standard/...` باشند و ساخت باید کاملاً آفلاین انجام شود.
+ **توجه:** فایل `docker-compose.yml` باید `version: "3"` باشد.
+ **توجه:** اگر *Redis* در دسترس نبود، گیتوی باید درخواست را رد نکند و اجازه دهد عبور کند، یعنی رفتار *fail-open*. این حالت تست نمیشود ولی سرویس نباید بهخاطرش از کار بیفتد.
+ **توجه:** فقط سرویس `edge` باید روی میزبان منتشر شود؛ `api` و `redis` نباید هیچ پورتی روی میزبان باز کنند.
+ **توجه:** هدرها و کدهای وضعیت باید دقیق باشند: `X-Cache` برابر `HIT` یا `MISS`، احراز هویت ناموفق `401`، عبور از سقف نرخ `429` و هر پاسخ یک `X-Request-Id` یکتا.
نمایشگر ابلفضلی سلیب
| پروژهٔ اولیهٔ این سوال را میتوانید از [این لینک](/contest/assignments/103145/download_problem_initial_project/356754/) دانلود کنید. |
| :-: |
تابلوی نتایج **جام جهانی فناوری پردیس ۲۰۲۶** قرار است روی یک کلاستر **کوبرنتیزی** بالا بیاید. یک سرویس *API* که نتایج را میدهد، سه تا ورکر که رویدادهای بازی را پردازش میکنند، یک ردیس، یک پستگرس و یک پرومتئوس و گرافانا برای اینکه ببینیم همهچیز سالم است یا نه. همهٔ اینها باید فقط با فایلهای *YAML* توصیف شوند و نوشتن همین فایلها کار شماست!
|  |
| :-: |
| نمای کلی از رصدخانهٔ جام: `Ingress`، دیپلوی `stable` و `canary`، سه ورکر، ردیس و پستگرس و در آخر پرومتئوس و گرافانا. |
+ **چهل و چهار فایل زیاد بهنظر میرسد، ولی لازم نیست همه را پیادهسازی کنید!** بهجز دو بخشی که در بخش **«سابتسکها»** در انتهای سوال بهصورت **«صفر و یکی»** علامت خوردهاند، بقیهٔ بخشها مستقل نمره میگیرند: اگر مثلا سه فایل را پیادهسازی کنید، نمرهٔ همان سه بخش را میگیرید و نه کمتر و نه بیشتر!
- **ولی یک شرط دارد:** هر فایلی که میفرستید باید *YAML* درست و ریسورس معتبر کوبرنتیز باشد. سه درصد اول بهصورت **صفر و یکی** داده میشود و اگر حتی یک فایل ناقص یا با `kind` اشتباه بفرستید، همان سه درصد را کامل از دست میدهید. پس فایل نصفهکاره نفرستید و فایلی را که ننوشتهاید اصلاً **نسازید.**
- دو درصد امتیاز جداگانه هم برای کامل بودن مجموعه است و وقتی داده میشود که سیستم داوری کوئرا با استفاده از `kubeconform` دستکم **۳۵ ریسورس** ببیند. یعنی اگر دنبال نمرهٔ کامل هستید، باید عملاً بیشتر فایلها را پیادهسازی کرده باشید.
# **پروژهٔ اولیه**
برای دانلود **پروژهٔ اولیه** روی [این لینک](/contest/assignments/103145/download_problem_initial_project/356754/) کلیک کنید. پروژه یک پوشهٔ `k8s/` دارد و شما باید فایلهای *YAML* را داخلش بسازید.
+ **مهمترین نکتهٔ این سؤال:** سیستم داوری فقط فایلهایی را میخواند که **اسمشان دقیقاً** یکی از اسمهای فهرست زیر باشد. اگر اسم فایل را عوض کنید، آن فایل اصلاً خوانده نمیشود و نمرهٔ آن بخش صفر میماند.
+ **دومین نکتهٔ مهم، اسم خودِ منابع است.** تستها منابع را با اسمشان پیدا میکنند، نه با اینکه در کدام فایل نوشته شدهاند. این چند اسم اجباریاند و اگر فرق کنند آن ریسورس **«پیدا نشده»** حساب میشود:
| **ریسورس** | **اسم اجباری** |
| --: | --: |
| کانتینر اصلی داخل `Deployment` سرویس *API* | `api` |
| `PriorityClass` مربوط به کارهای بچ | `scoreboard-batch` |
| لیبلی که نسخهٔ `stable` را از `canary` جدا میکند | کلید `track` با مقدار `stable` یا `canary` |
| `Role` و `RoleBinding`ها | باید با `scoreboard` شروع شوند |
> اسم `Deployment`ها و `Service`ها را هم در همان جدولهای هر بخش آوردهایم. قاعدهٔ کلی این است که هر چیزی با پیشوند `scoreboard` میآید، بهجز پرومتئوس و گرافانا که اسمشان `prometheus` و `grafana` است.
<details class="grey">
<summary>**نکته: فهرست دقیق فایلهایی که باید بسازید**</summary>
در هر فایل میتوانید بیش از یک ریسورس بگذارید و با `---` از هم جدایشان کنید. ولی اسم فایل باید دقیقاً یکی از اینها باشد:
```
k8s/
├── <mark class="green" title="باید پیادهسازی شود">00-namespace.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">01-priorityclass.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">02-resourcequota.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">03-limitrange.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">04-storageclass.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">05-crd-vpa.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">06-crd-servicemonitor.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">10-configmap-app.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">11-configmap-proxy.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">12-configmap-prometheus.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">13-configmap-grafana.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">14-secret-db.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">15-secret-api.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">16-secret-tls.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">20-rbac-serviceaccounts.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">21-rbac-roles.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">22-rbac-clusterrole.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">23-rbac-bindings.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">30-api-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">31-api-service.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">32-ingester-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">33-aggregator-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">34-notifier-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">35-worker-services.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">36-api-canary-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">40-redis-statefulset.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">41-redis-service.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">42-postgres-statefulset.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">43-postgres-service.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">50-prometheus-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">51-prometheus-service.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">52-grafana-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">53-grafana-service.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">54-servicemonitor.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">60-ingress.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">70-hpa.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">71-vpa.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">72-pdb.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">80-netpol-default-deny.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">81-netpol-redis.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">82-netpol-db.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">83-netpol-api.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">90-job-migrate.yml</mark>
└── <mark class="green" title="باید پیادهسازی شود">91-cronjob-archive.yml</mark>
```
</details>
# **جزئیات**
## **داوری چطور کار میکند**
سیستم داوری کوئرا **هیچ کلاستری بالا نمیآورد و هیچ پادی را اجرا نمیکند! عملا به دلیل حجم بالای شرکتکنندهها این کار به کل امکان پذیر نخواهد بود.** سیستم داوری فایلهای *YAML* شما را میخواند و نگاه میکند که منابع درست به هم وصل شدهاند یا نه. این کار شدنی است چون در کوبرنتیز همهچیز داخل خود *YAML* نوشته میشود: اینکه `selector` یک `Service` کدام پادها را میگیرد، اینکه `scaleTargetRef` یک `HorizontalPodAutoscaler` به کدام `Deployment` اشاره میکند، همه در فایل هست. در آخر هم اسکیمای فایلها را با `kubeconform` راستیآزمایی میکند.
+ **توجه:** عددهای دلخواه مثل تعداد رپلیکا، درصد *CPU* یا مقدار حافظه سنجیده **نمیشوند**. آنچه سنجیده میشود این است که منابع درست به هم وصل شده باشند.
+ **توجه:** اسم ایمیجها فقط یک رشتهٔ متنی است و هیچ ایمیجی پول یا اجرا نمیشود. هر اسمی بگذارید مشکلی ندارد.
همهٔ منابعی که `namespace` میخواهند باید داخل `jaam-rasadkhane` تعریف شوند. این اسمها هم قراردادیاند، چون هم منابع دیگر و هم سیستم داوری با همین اسمها دنبالشان میگردند:
| **چیزی که میسازید** | **اسمی که باید بگذارید** |
| --: | --: |
| `Namespace` | `jaam-rasadkhane` |
| `Deployment` و `Service` سرویس *API* | `scoreboard-api` |
| `Deployment` کاناری | `scoreboard-api-canary` |
| `StatefulSet` و `Service` ردیس | `redis` |
| `StatefulSet` و `Service` پستگرس | `scoreboard-db` |
| سه ورکر | `scoreboard-ingester` و `scoreboard-aggregator` و `scoreboard-notifier` |
| پرومتئوس و گرافانا | `prometheus` و `grafana` |
| `ConfigMap` برنامه | `scoreboard-config` |
| `ConfigMap` پرومتئوس | `prometheus-config` |
| `Secret` پستگرس | `scoreboard-db-secret` |
| `Secret` توکن *API* | `scoreboard-api-token` |
| `ServiceAccount`ها | `scoreboard-api-sa` و `scoreboard-worker-sa` و یکی برای پرومتئوس |
لیبلها هم بخشی از قرارداداند، چون `Service` و `NetworkPolicy` و `ServiceMonitor` با همینها همدیگر را پیدا میکنند. روی پادهای *API* این دو لیبل را بگذارید:
```yaml k8s/30-api-deployment.yml kubernetes
labels:
app: scoreboard
component: api
```
> همین جفت باید هم در `spec.selector.matchLabels` دیپلویمنت، هم در `spec.template.metadata.labels` پاد و هم در `selector` سرویس `scoreboard-api` تکرار شود. برای سه ورکر و لایهٔ داده هم `app` را `scoreboard` نگه دارید و فقط `component` را عوض کنید، مثلاً `ingester` یا `redis`. لیبل نسخه که برای کاناری لازم است جدا از این دوتاست و **نباید** داخل `selector` سرویس بیاید.
|  |
| :-: |
| معماری سیستم: `Ingress`، پادهای *API* با `initContainers` و سایدکار، سه ورکر، ردیس و پستگرس، پرومتئوس و گرافانا. |
## **فایلهای** `Namespace` **و** `PriorityClass`
<details class="blue">
<summary>**فایلهای `00-namespace.yml` و `01-priorityclass.yml`**</summary>
یک `Namespace` به اسم `jaam-rasadkhane` بسازید و چند لیبل توصیفی رویش بگذارید. این `Namespace` باید لیبلهای *Pod Security Admission* را هم داشته باشد تا پادهای ناامن داخلش قبول نشوند:
```yaml k8s/00-namespace.yml kubernetes
apiVersion: v1
kind: Namespace
metadata:
name: jaam-rasadkhane
labels:
app: scoreboard
pod-security.kubernetes.io/enforce: baseline
pod-security.kubernetes.io/audit: baseline
pod-security.kubernetes.io/warn: baseline
```
> سه لیبلی که با `pod-security.kubernetes.io/` شروع میشوند همان چیزی هستند که کوبرنتیز برای *Pod Security Admission* نگاه میکند. لیبل `enforce` جلوی ساخته شدن پاد ناامن را میگیرد و دوتای دیگر فقط هشدار میدهند. اسم `Namespace` باید دقیقاً `jaam-rasadkhane` باشد چون بقیهٔ فایلها به آن ارجاع میدهند.
>
> **یک نکتهٔ مهم:** چون در این سوال هیچ کلاستری اجرا نمیشود، این لیبلها **بهصورت متنی** بررسی میشوند و واقعاً روی پادها اعمال نمیشوند. یعنی لازم نیست همهٔ کانتینرهای همهٔ سرویسها را با سطح `restricted` سازگار کنید؛ فقط جایی که متن صریحاً `securityContext` خواسته، یعنی کانتینر اصلی *API*، آن را بنویسید. هر سه لیبل باید مقدار یکسانی داشته باشند و هر سه سطح معتبر (`privileged`، `baseline` یا `restricted`) پذیرفته میشود.
بعد **سه** `PriorityClass` بسازید که عددشان با هم فرق دارد. `PriorityClass` اهمیت یک پاد را برای `scheduler` مشخص میکند: پاد با اولویت بالاتر زودتر زمانبندی میشود و در صورت کمبود منابع میتواند باعث *preemption* پادهای کماولویتتر شود.
- یکی با عدد بالا، برای پادهای مهم مثل سرویس *API* و پستگرس.
- یکی با عدد متوسط، برای ورکرها و پرومتئوس و گرافانا.
- یکی با عدد پایین، برای `Job` و `CronJob`.
پادهای *API* باید از کلاس عدد بالا استفاده کنند و `Job` و `CronJob` از کلاس عدد پایین. فقط ترتیب نسبی `high > medium > low` سنجیده میشود و مقدار عددی هرکدام دلخواه است.
</details>
## **فایل** `ResourceQuota` **و** `LimitRange`
<details class="green">
<summary>**فایلهای `02-resourcequota.yml` و `03-limitrange.yml`**</summary>
یک `ResourceQuota` بسازید که **هر دو** چیز زیر را داشته باشد:
- سقف مجموع *CPU* و حافظه، هم برای `requests` و هم برای `limits`.
- سقف تعداد اشیا، مثلاً تعداد پاد یا `Service` یا `Secret`.
بعد یک `LimitRange` بسازید که برای کانتینرهای این `Namespace` مقدار پیشفرض و حداقل و حداکثر *CPU* و حافظه را مشخص کند، تا هیچ کانتینری بدون `limits` بالا نیاید. عددها دلخواه شماست و فقط وجود این سه چیز چک میشود.
</details>
## **فایل** `StorageClass`
<details class="yellow">
<summary>**فایل `04-storageclass.yml`**</summary>
یک `StorageClass` بسازید که فیلد `provisioner` داشته باشد. این ریسورس مشخص میکند `PersistentVolume`ها چطور بهصورت خودکار ساخته شوند و `reclaimPolicy` آنها بعد از آزاد شدن از `PersistentVolumeClaim` چه باشد.
هر دو `volumeClaimTemplate` ردیس و پستگرس باید `storageClassName` را برابر اسم همین `StorageClass` بگذارند.
</details>
## **فایل** `ConfigMap` و `Secret`
<details class="violet">
<summary>**فایلهای `10` تا `16`**</summary>
چیزهای معمولی داخل `ConfigMap` و چیزهای حساس داخل `Secret`. چهار `ConfigMap` بسازید:
| **فایل** | **اسم** `ConfigMap` | **داخلش چه باید باشد** |
| --: | --: | --: |
| `10-configmap-app.yml` | `scoreboard-config` | کلید `REDIS_ADDR` با آدرس ردیس و کلید `DB_HOST` با آدرس پستگرس، بهاضافهٔ هر کلید دیگری که لازم دارید |
| `11-configmap-proxy.yml` | هر اسمی | کانفیگ کانتینر سایدکار |
| `12-configmap-prometheus.yml` | `prometheus-config` | کانفیگ پرومتئوس که حتماً بخش `scrape_configs` را داشته باشد |
| `13-configmap-grafana.yml` | هر اسمی | تعریف *datasource* گرافانا |
و سه `Secret`:
| **فایل** | **اسم** `Secret` | `type` | **کلیدها** |
| --: | --: | --: | --: |
| `14-secret-db.yml` | `scoreboard-db-secret` | `Opaque` | `POSTGRES_USER` و `POSTGRES_PASSWORD` |
| `15-secret-api.yml` | `scoreboard-api-token` | `Opaque` | توکن سرویس *API* |
| `16-secret-tls.yml` | هر اسمی | `kubernetes.io/tls` | `tls.crt` و `tls.key` |
```yaml k8s/14-secret-db.yml kubernetes
apiVersion: v1
kind: Secret
metadata:
name: scoreboard-db-secret
namespace: jaam-rasadkhane
type: Opaque
data:
POSTGRES_USER: c2NvcmVib2FyZA==
POSTGRES_PASSWORD: cGFyZGlzLTIwMjYtc2VjcmV0
```
> حتماً از کلید `data` استفاده کنید و نه `stringData`. هر دو روی یک کلاستر واقعی کار میکنند، ولی چون در این سوال هیچ کلاستری اجرا نمیشود، تستها خودِ فایل شما را میخوانند و فقط داخل `data` را نگاه میکنند؛ با `stringData` نمرهٔ این بخش صفر میشود. مقدارها باید *base64* شده باشند و با `printf 'scoreboard' | base64` میتوانید بسازیدشان. اسم `scoreboard-db-secret` و اسم دو کلید `POSTGRES_USER` و `POSTGRES_PASSWORD` اجباریاند چون `StatefulSet` پستگرس از همینها میخواند. `Secret` مربوط به *TLS* باید `type` برابر `kubernetes.io/tls` داشته باشد؛ این همان نوعی است که `Ingress` برای گواهی انتظار دارد و داوری هم همین را میسنجد.
</details>
## **فایل** `ServiceAccount` **و** `RBAC`
<details class="blue">
<summary>**فایلهای `20` تا `23`**</summary>
قاعده این است که هر سرویس فقط همان دسترسیای را داشته باشد که واقعاً لازم دارد. بهجای یک اکانت مشترک، برای هر کدام یک `ServiceAccount` جدا بسازید: دستکم `scoreboard-api-sa` برای *API*، `scoreboard-worker-sa` برای ورکرها و یکی برای پرومتئوس.
بعد دو سطح دسترسی بسازید:
- **دو `Role`** در `21-rbac-roles.yml`. `Role` فقط داخل همین `Namespace` کار میکند. مثلاً اجازهٔ `get` و `list` روی `configmaps` و `pods`. اجازهٔ نوشتن گسترده ندهید.
- **دو `ClusterRole`** در `22-rbac-clusterrole.yml`. `ClusterRole` در کل کلاستر کار میکند، پس دسترسی را تا حد ممکن محدود کنید. مثلاً فقط خواندن `nodes` برای پرومتئوس.
+ **توجه:** هیچکدام از این `Role`ها و `ClusterRole`ها نباید `*` روی `resources` و `verbs` بدهند. سیستم داوری همین را چک میکند.
```yaml k8s/22-rbac-clusterrole.yml kubernetes
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
name: scoreboard-prometheus-reader
rules:
- apiGroups: [""]
resources: ["nodes", "nodes/metrics", "services", "endpoints", "pods"]
verbs: ["get", "list", "watch"]
```
> این `ClusterRole` فقط اجازهٔ خواندن میدهد و هیچ فعل نوشتنی مثل `create` یا `delete` ندارد. رشتهٔ خالی در `apiGroups` یعنی گروه اصلی کوبرنتیز، جایی که `pods` و `services` در آن هستند. اگر بهجای این فهرست، `resources: ["*"]` و `verbs: ["*"]` بنویسید، تست مربوط به این بخش رد میشود.
در `23-rbac-bindings.yml` این نقشها را وصل کنید: یک `RoleBinding` برای `scoreboard-api-sa`، یک `RoleBinding` برای `scoreboard-worker-sa` و دستکم یک `ClusterRoleBinding`. هر `Deployment` هم باید در `spec.template.spec.serviceAccountName` اکانت خودش را بنویسد.
</details>
| 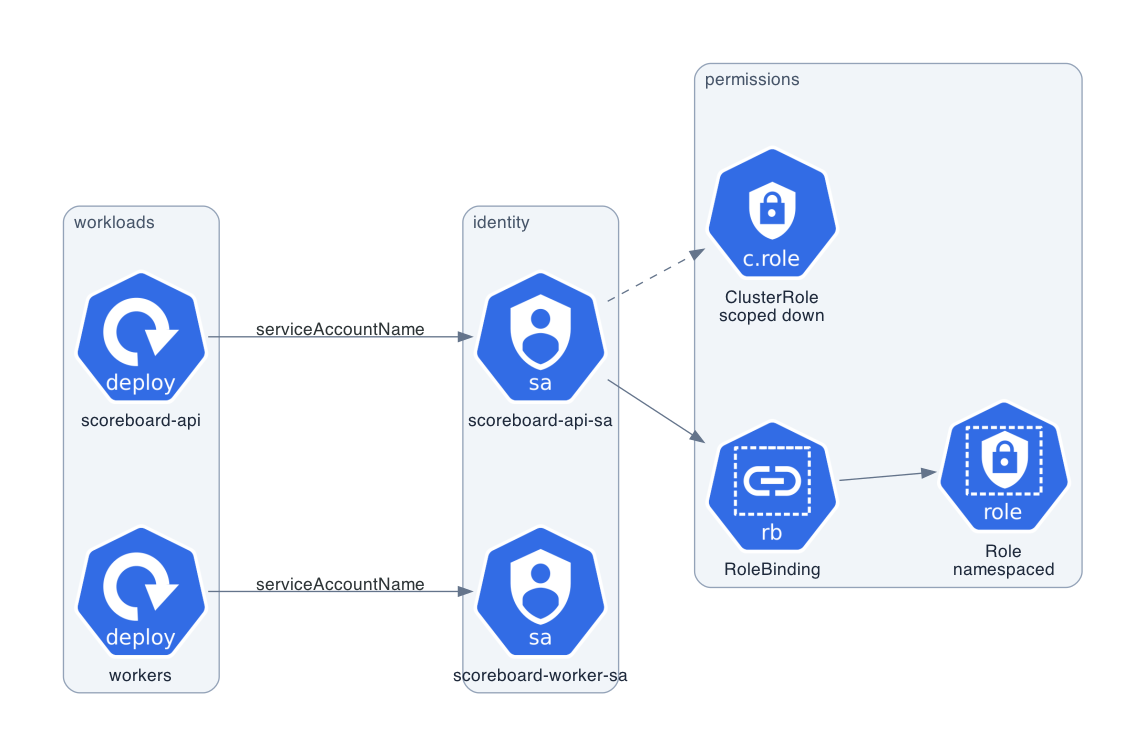 |
| :-: |
| سه `ServiceAccount`، هرکدام به `Role`ها و `ClusterRole`های محدود وصل میشوند. |
## **فایل** `Deployment` **سرویس** *API*
<details class="green">
<summary>**فایل `30-api-deployment.yml`، پرامتیازترین فایل این سؤال**</summary>
یک `Deployment` به اسم `scoreboard-api` با چند تا رپلیکا بسازید. دقت کنید `spec.selector.matchLabels` با لیبلهای `spec.template.metadata.labels` یکی باشد، وگرنه `Deployment` پادهای خودش را پیدا نمیکند.
کانتینر اصلی باید اینها را داشته باشد:
- پورت `8080`.
- خواندن کانفیگ از `scoreboard-config` و مقدارهای حساس از `Secret`ها.
- `livenessProbe` و `readinessProbe`.
- `resources` با هر دو بخش `requests` و `limits` برای *CPU* و حافظه.
- `securityContext` امن: `allowPrivilegeEscalation: false`، اجرا با کاربر غیر روت و یک `seccompProfile`.
```yaml k8s/30-api-deployment.yml kubernetes
securityContext:
allowPrivilegeEscalation: false
runAsNonRoot: true
runAsUser: 10001
capabilities:
drop: ["ALL"]
seccompProfile:
type: RuntimeDefault
```
> این تکه داخل کانتینر اصلی میآید. فیلد `allowPrivilegeEscalation: false` جلوی این را میگیرد که پروسه داخل کانتینر دسترسی خودش را بالا ببرد. فیلد `runAsNonRoot: true` به کوبرنتیز میگوید اگر ایمیج بخواهد با روت بالا بیاید اصلاً اجرایش نکند. مقدار `RuntimeDefault` برای `seccompProfile` هم فیلتر پیشفرض سیستمکالها را روشن میکند. بدون این چهار چیز، هم تست مربوط به امنیت رد میشود و هم `Namespace` با سطح `restricted` پاد را قبول نمیکند.
علاوه بر کانتینر اصلی، این پاد باید دو چیز دیگر هم داشته باشد:
- **بیش از یک `initContainer`.** اینها قبل از کانتینر اصلی اجرا میشوند و منتظر میمانند تا ردیس و پستگرس بالا بیایند. یعنی `initContainers` باید دستکم دو عضو داشته باشد.
- **یک کانتینر سایدکار** که کنار کانتینر اصلی در همان پاد بالا میآید، متریک میدهد و یک `containerPort` با `name: metrics` باز میکند.
آخرین چیز، پادهای *API* نباید همه روی یک نود جمع شوند، چون اگر آن نود از کار بیفتد کل سرویس میخوابد. برای این کار `affinity` یا `podAntiAffinity` تعریف کنید و `topologySpreadConstraints` هم بگذارید.
</details>
| 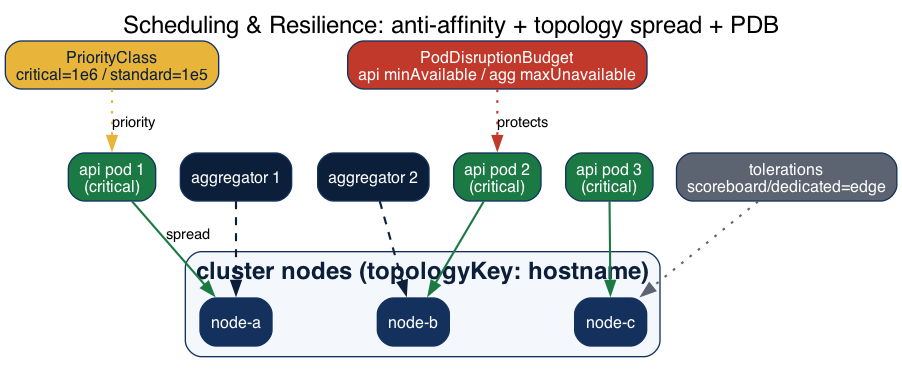 |
| :-: |
| قواعد `podAntiAffinity` و `topologySpreadConstraints` پادهای *API* را روی نودها پخش میکنند و `PodDisruptionBudget` از آنها محافظت میکند. |
## **فایل** `Service` **مشترک و دیپلوی کاناری**
<details class="violet">
<summary>**فایلهای `31-api-service.yml` و `36-api-canary-deployment.yml`**</summary>
یک `Service` از نوع `ClusterIP` به اسم `scoreboard-api` بسازید که پادهای *API* را بگیرد و ترافیک را به پورت `8080` کانتینر برساند. `selector` این `Service` باید واقعاً با لیبلهای پادهای *API* بخواند، چون سیستم داوری همین تطابق را چک میکند.
حالا برای اینکه بشود نسخهٔ جدید *API* را روی سهم کوچکی از ترافیک امتحان کرد، یک `Deployment` دوم به اسم `scoreboard-api-canary` بسازید. ساختارش شبیه دیپلویمنت اصلی است، با این تفاوتها:
- دیپلویمنت اصلی باید یک لیبل نسخه با مقدار `stable` داشته باشد و کاناری همان لیبل را با مقدار `canary`.
- تعداد رپلیکای کاناری باید **کمتر** از رپلیکای اصلی باشد.
- کاناری هم باید همان `scoreboard-config` را بخواند.
+ **کل نکتهٔ این بخش این است:** یک `Service` مشترک باید **هر دو** دیپلویمنت را بگیرد. یعنی `selector` سرویس فقط روی لیبلهای مشترک مثل `app` و `component` باشد و **نباید** لیبل نسخه را فیلتر کند.
```yaml k8s/31-api-service.yml kubernetes
spec:
type: ClusterIP
selector:
app: scoreboard
component: api
ports:
- name: http
port: 80
targetPort: 8080
```
> این `selector` عمداً لیبل نسخه را ندارد. به همین دلیل هم پادهای `stable` و هم پادهای `canary` وارد `Endpoints` این `Service` میشوند. در عمل سهم هر نسخه به تعداد `Endpoint`های آمادهٔ آن نسخه بستگی دارد، ولی کوبرنتیز درصد دقیق و ثابتی برای هر نسخه تضمین نمیکند؛ برای وزندهی دقیق به یک لایهٔ مسیریابی جداگانه نیاز است. اگر لیبل نسخه را داخل `selector` بگذارید، سرویس فقط یکی از دو نسخه را میگیرد و تست این بخش رد میشود.
</details>
## **فایل ورکرها**
<details class="blue">
<summary>**فایلهای `32` تا `35`**</summary>
سه `Deployment` جدا بسازید:
| **فایل** | **اسم** `Deployment` | **وظیفه** |
| --: | --: | --: |
| `32-ingester-deployment.yml` | `scoreboard-ingester` | گرفتن و چک کردن رویدادهای بازی |
| `33-aggregator-deployment.yml` | `scoreboard-aggregator` | جمع کردن امتیاز و گل |
| `34-notifier-deployment.yml` | `scoreboard-notifier` | فرستادن اعلان |
هر سه باید کانفیگ را از `scoreboard-config` بگیرند، با `scoreboard-worker-sa` اجرا شوند، `resources.requests` داشته باشند و یک `containerPort` با `name: metrics` باز کنند. این ورکرها سرور *HTTP* عمومی ندارند و فقط در پسزمینه کار میکنند.
در `35-worker-services.yml` برای هر ورکر یک `Service` بسازید که پورت `metrics` را عرضه کند، تا پرومتئوس بتواند از آنها متریک بخواند. تعداد رپلیکاها دلخواه شماست.
</details>
|  |
| :-: |
| مسیر یک رویداد: از *API* به ردیس، مصرف توسط ورکرها، ذخیره در پستگرس و بازتاب در متریکها. |
## **فایلهای ردیس و پستگرس**
<details class="green">
<summary>**فایلهای `40` تا `43`**</summary>
ردیس و پستگرس داده نگه میدارند، پس بهجای `Deployment` باید `StatefulSet` باشند. `StatefulSet` برای هر پاد یک هویت پایدار و یک `PersistentVolumeClaim` اختصاصی میسازد، بنابراین پاد بعد از ساخته شدن دوباره به همان ولوم قبلی وصل میشود.
**ردیس** را در `40-redis-statefulset.yml` بهصورت `StatefulSet` با اسم `redis` بنویسید که:
- فیلد `serviceName` آن `redis` باشد.
- کانتینر ردیس روی پورت `6379` باشد.
- یک `volumeClaimTemplate` داشته باشد.
بعد در `41-redis-service.yml` یک `Service` با `clusterIP: None` و اسم `redis` بسازید:
```yaml k8s/41-redis-service.yml kubernetes
apiVersion: v1
kind: Service
metadata:
name: redis
namespace: jaam-rasadkhane
spec:
clusterIP: None
selector:
app: scoreboard
component: redis
ports:
- name: redis
port: 6379
targetPort: 6379
```
> فیلد `clusterIP: None` این `Service` را *headless* میکند. یعنی کوبرنتیز برایش یک *IP* مجازی نمیسازد و بهجایش برای هر پاد یک رکورد *DNS* جدا میسازد. `StatefulSet` دقیقاً به همین احتیاج دارد تا هر پاد اسم پایدار خودش را داشته باشد و بعد از ریاستارت هم با همان اسم پیدا شود. اسم این `Service` باید با `serviceName` داخل `StatefulSet` یکی باشد، وگرنه اسمهای *DNS* ساخته نمیشوند.
**پستگرس** را در `42-postgres-statefulset.yml` بهصورت `StatefulSet` با اسم `scoreboard-db` بنویسید که روی پورت `5432` باشد، یوزر و پسورد را از `scoreboard-db-secret` بگیرد و آن هم `volumeClaimTemplate` داشته باشد. بعد در `43-postgres-service.yml` یک `Service` معمولی با اسم `scoreboard-db` روی پورت `5432` بسازید.
</details>
## **فایلهای پرومتئوس و گرافانا**
<details class="violet">
<summary>**فایلهای `50` تا `54` و `06`**</summary>
یک `Deployment` به اسم `prometheus` بسازید که `prometheus-config` را بهصورت ولوم مانت کند، با `ServiceAccount` خودش اجرا شود و `Service` آن روی پورت `9090` باشد. پرومتئوس باید بتواند پورت `metrics` سرویس *API* و هر سه ورکر را بخواند.
کنارش یک `Deployment` به اسم `grafana` بسازید که پسورد ادمینش را از یک `Secret` بگیرد و `Service` آن روی پورت `3000` باشد.
بعد `ServiceMonitor` را اضافه کنید. `ServiceMonitor` ریسورس استاندارد کوبرنتیز نیست؛ ریسورسی سفارشی است که *Prometheus Operator* تعریف میکند. روی یک کلاستر واقعی، تا `CRD` آن اعمال نشده باشد سرور *API* چنین ریسورسی را نمیشناسد. در این سوال کلاستری اجرا نمیشود، ولی چون بخشی از کار همین اعلام کردن قرارداد ریسورس است، هر دو فایل خواسته میشوند:
- در `06-crd-servicemonitor.yml` تعریف `CustomResourceDefinition` مربوط به `ServiceMonitor` را بگذارید.
- در `54-servicemonitor.yml` یک ریسورس `ServiceMonitor` بسازید که با `selector` خودش دستکم `Service` سرویس *API* را برای خواندن متریک انتخاب کند.
+ **توجه:** بدون فایل `06`، ریسورس داخل فایل `54` بیمعنی است و تست این بخش رد میشود. هر دو فایل لازماند.
</details>
| 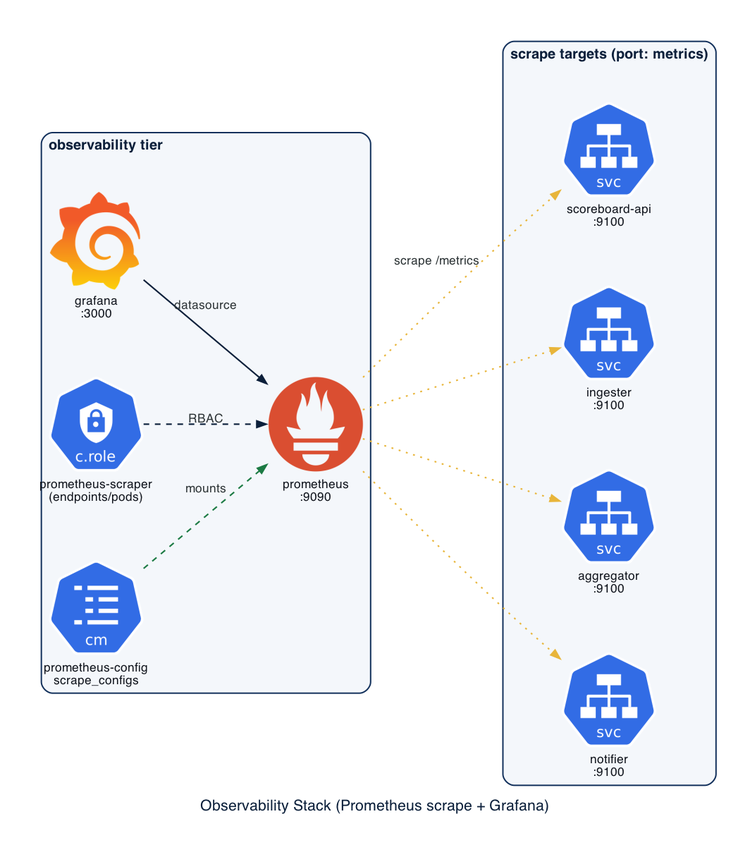 |
| :-: |
| پرومتئوس پورت `metrics` سرویس *API* و ورکرها را میخواند و گرافانا آن را بهعنوان *datasource* نشان میدهد. |
## **فایل** *Ingress*
<details class="blue">
<summary>**فایل `60-ingress.yml`**</summary>
یک `Ingress` بسازید که ترافیک بیرون را به `Service` با اسم `scoreboard-api` بفرستد و یک بخش `tls` داشته باشد که به `Secret` مربوط به *TLS* اشاره میکند. یک `host` و `path` هم تعریف کنید و اگر لازم شد `ingressClassName` را بنویسید. `Ingress` باعث میشود بهجای باز کردن مستقیم سرویسها به بیرون، فقط یک در ورودی داشته باشیم.
</details>
|  |
| :-: |
| مسیر کامل درخواست از `Ingress` با *TLS* تا پادهای *API* و پستگرس، محدودشده با `NetworkPolicy`. |
## **فایلهای اتواسکیلینگ**
<details class="green">
<summary>**فایلهای `70-hpa.yml` و `71-vpa.yml` و `05-crd-vpa.yml`**</summary>
در `70-hpa.yml` **دو** `HorizontalPodAutoscaler` بسازید، یکی برای `scoreboard-api` و یکی برای `scoreboard-aggregator`. هرکدام باید:
- `minReplicas` و `maxReplicas` داشته باشند، طوری که `maxReplicas` از `minReplicas` کوچکتر نباشد.
- دستکم یک `metrics` تعریف کنند، مثلاً مصرف *CPU*.
- در `scaleTargetRef` اسم درست `Deployment` را بنویسند.
```yaml k8s/70-hpa.yml kubernetes
spec:
scaleTargetRef:
apiVersion: apps/v1
kind: Deployment
name: scoreboard-api
minReplicas: 3
maxReplicas: 10
metrics:
- type: Resource
resource:
name: cpu
target:
type: Utilization
averageUtilization: 70
```
> بخش `scaleTargetRef` میگوید این *HPA* روی کدام `Deployment` کار کند و اسمش باید دقیقاً با اسم دیپلویمنت یکی باشد. بخش `metrics` هم معیار را مشخص میکند: اینجا اگر میانگین مصرف *CPU* پادها از ۷۰ درصدِ `requests` بالاتر برود، تعداد رپلیکا زیاد میشود. دقت کنید که *HPA* برای کار کردن به `resources.requests` روی کانتینر احتیاج دارد، پس اگر آن را ننوشته باشید در عمل کار نمیکند.
در `71-vpa.yml` یک `VerticalPodAutoscaler` بسازید که یکی از سرویسها را هدف بگیرد. *VPA* هم مثل `ServiceMonitor` یک ریسورس سفارشی است، پس `CRD` آن را در `05-crd-vpa.yml` بگذارید.
</details>
|  |
| :-: |
| *HPA* تعداد رپلیکاها را با بار تنظیم میکند و *VPA* اندازهٔ منابع هر پاد را. |
## **فایل** `PodDisruptionBudget`
<details class="yellow">
<summary>**فایل `72-pdb.yml`**</summary>
`PodDisruptionBudget` مشخص میکند هنگام *voluntary disruption*، مثلاً `kubectl drain` روی یک نود، حداکثر چند پاد از یک سرویس میتوانند همزمان از دسترس خارج شوند. این ریسورس جلوی خراب شدن ناگهانی نود یا حذف مستقیم پاد توسط ادمین را نمیگیرد.
دستکم **دو** بسازید که لایههای مختلف را پوشش دهند. یکی از آنها حتماً باید پادهای *API* را هدف بگیرد و با `minAvailable` یا `maxUnavailable` حد را مشخص کند. عددها دلخواه شماست.
</details>
## **فایل** `NetworkPolicy`
<details class="violet">
<summary>**فایلهای `80` تا `83`**</summary>
بهصورت پیشفرض در کوبرنتیز هر پاد میتواند به هر پاد دیگری وصل شود. با `NetworkPolicy` این را میبندیم و فقط چیزهای لازم را باز میکنیم:
- در `80-netpol-default-deny.yml` یک `NetworkPolicy` بسازید که کل `Namespace` را هدف بگیرد و **هم `Ingress` و هم `Egress`** را ببندد.
- در `81-netpol-redis.yml` یک سیاست برای پادهای ردیس که **هر دو جهت** را محدود کند: فقط پادهای این سیستم اجازهٔ اتصال روی پورت `6379` داشته باشند.
+ **دو سیاست ردیس و پایگاهداده با لیبل هدفگیری میشوند.** `podSelector` هرکدام باید دقیقاً روی `component: redis` و `component: db` بنشیند و `policyTypes` هر دو باید **هم `Ingress` و هم `Egress`** را داشته باشد. اگر لیبل دیگری بگذارید، سیاست پیدا نمیشود؛ پس مطمئن شوید پادهای ردیس و پستگرس هم همین لیبل `component` را روی خودشان دارند.
- در `82-netpol-db.yml` همین کار را برای پستگرس بکنید، باز هم با محدود کردن هر دو جهت.
- در `83-netpol-api.yml` سیاست مربوط به پادهای *API*. این فایل نمرهٔ مستقلی ندارد و اختیاری است، ولی برای کامل بودن مدل امنیتی توصیه میشود.
```yaml k8s/80-netpol-default-deny.yml kubernetes
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
name: default-deny-all
namespace: jaam-rasadkhane
spec:
podSelector: {}
policyTypes:
- Ingress
- Egress
```
> فیلد `podSelector: {}` یعنی این سیاست روی **همهٔ** پادهای این `Namespace` اعمال میشود. چون `policyTypes` هر دو مقدار `Ingress` و `Egress` را دارد ولی هیچ قانون `ingress` یا `egress` نوشته نشده، نتیجهاش بستن کامل هر دو جهت است. بعد از این فایل، هر ارتباطی که واقعاً لازم دارید را باید در فایلهای `81` تا `83` صریحاً باز کنید. سیستم داوری وجود همین سیاست پیشفرض و پوشش هر دو جهت در سیاستهای ردیس و پستگرس را چک میکند.
</details>
| 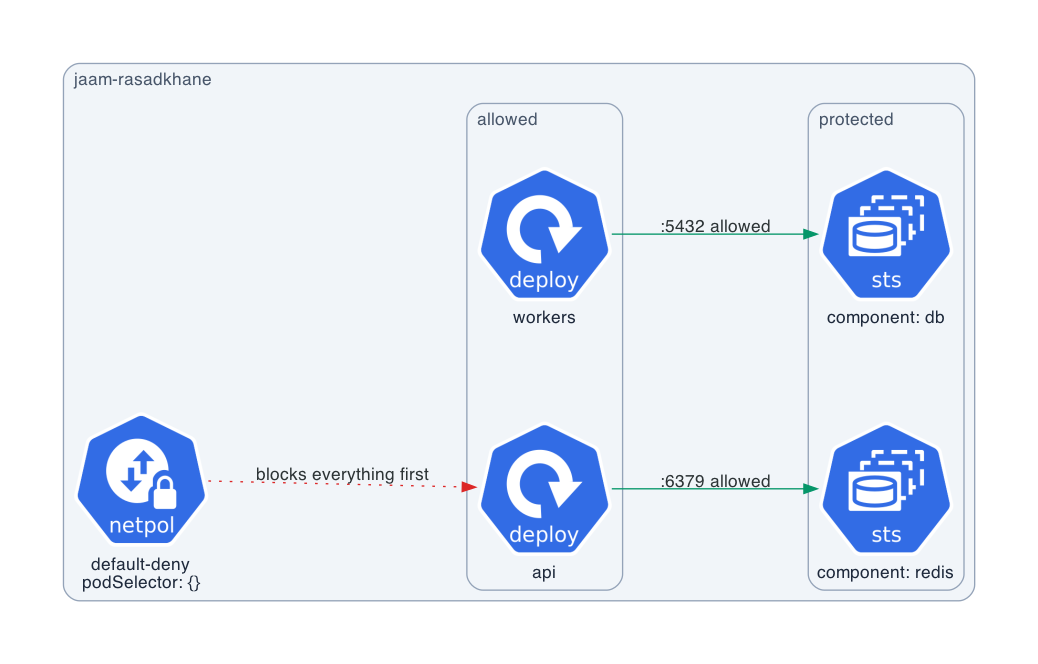 |
| :-: |
| لیبلهای *Pod Security*، `securityContext` کانتینرها، `NetworkPolicy`ها و `RBAC` محدود در کنار هم. |
## **فایلهای** `Job` و `CronJob`
<details class="blue">
<summary>**فایلهای `90-job-migrate.yml` و `91-cronjob-archive.yml`**</summary>
دو تا کار پسزمینه تعریف کنید:
- در `90-job-migrate.yml` یک `Job` یکباره برای مایگریشن دیتابیس. فیلد `restartPolicy` پادش باید `OnFailure` یا `Never` باشد (مقدار پیشفرض `Always` است و `Job` قبولش نمیکند). قبل از کانتینر اصلی هم یک `initContainer` بگذارید که منتظر بالا آمدن پستگرس بماند.
- در `91-cronjob-archive.yml` یک `CronJob` برای بایگانی دورهای با یک `schedule` معتبر. `restartPolicy` داخل قالب کارش هم باید `OnFailure` یا `Never` باشد.
هر دو با `scoreboard-worker-sa` اجرا میشوند و باید `priorityClassName` را روی همان کلاس عدد پایین بگذارند تا موقع کمبود منابع زودتر از سرویسهای اصلی کنار بروند.
</details>
# **بررسی وضعیت اسکیماها**
بعد از نوشتن فایلها میتوانید خودتان اسکیمایشان را با `kubeconform` چک کنید. این همان کاری است که سیستم داوری در آخر انجام میدهد:
```bash terminal terminal
kubeconform -summary -ignore-missing-schemas k8s/*.yml
```
> این دستور همهٔ فایلهای پوشهٔ `k8s/` را میخواند و هر ریسورس را با اسکیمای رسمی کوبرنتیز مقایسه میکند. فلگ `-ignore-missing-schemas` باعث میشود منابع سفارشی مثل `VerticalPodAutoscaler` و `ServiceMonitor` که اسکیمای عمومی ندارند بهجای خطا دادن در دستهٔ `Skipped` بروند. خروجی موفق چیزی شبیه خط زیر است و عددها بسته به اینکه چند تکه را نوشتهاید فرق میکند.
```text output terminal
Summary: 61 resources found in 44 files - Valid: 56, Invalid: 0, Errors: 0, Skipped: 5
```
جدا از اسکیما، سیستم داوری وصل بودن منابع به هم را هم چک میکند. مثلاً میبیند `selector` سرویس *API* واقعاً پادهای دیپلویمنت *API* را میگیرد یا نه:
```text output terminal
service/scoreboard-api selector: {app: scoreboard, component: api} -> 3 api pods
```
و اینکه `scaleTargetRef` مربوط به *HPA* واقعاً به دیپلویمنت *API* اشاره میکند یا نه:
```text output terminal
hpa/scoreboard-api-hpa scaleTargetRef -> Deployment/scoreboard-api min:3 max:10
```
> این دو خط نمونهای از چیزی هستند که سیستم داوری از روی *YAML* بیرون میکشد. اگر لیبلهای پاد با `selector` سرویس نخوانند یا اسم داخل `scaleTargetRef` اشتباه باشد، آن بخش رد میشود حتی اگر فایل از نظر اسکیما کاملاً معتبر باشد. به همین دلیل رعایت اسمهای جدول بالا مهم است.
## **سابتسکها**
هر ردیف در سیستم داوری مستقل نمره میگیرد. از این جدول برای انتخاب مسیر خودتان استفاده کنید:
| **بخش** | **فایلها** | **درصد** |
| --: | --: | :-: |
| ارسال معتبر و رد شدن از `kubeconform` | همه | ۵ |
| `Namespace` و لیبلهای *Pod Security* | `00` | ۲ |
| سه `PriorityClass` و کلاس بچ | `01` | ۴ |
| `ResourceQuota` و `LimitRange` | `02`، `03` | ۴ |
| `StorageClass` | `04` | ۲ |
| `ConfigMap`ها | `10` تا `13` | ۴ |
| `Secret`ها | `14`، `15`، `16` | ۵ |
| `ServiceAccount` و `Role` و `ClusterRole` و بایندینگها | `20` تا `23` | ۸ |
| `Deployment` سرویس *API* | `30` | ۱۴ |
| `Service` مشترک *API* | `31` | ۲ |
| سه ورکر و `Service` متریکشان | `32` تا `35` | ۸ |
| دیپلوی کاناری | `36`، `13` | ۵ |
| ردیس و پستگرس | `40` تا `43` | ۸ |
| پرومتئوس و گرافانا | `50` تا `53` | ۸ |
| `ServiceMonitor` و *CRD* آن | `06`، `54` | ۳ |
| `Ingress` با *TLS* | `60` | ۲ |
| `HorizontalPodAutoscaler` و `VerticalPodAutoscaler` | `70`، `71`، `05` | ۴ |
| `PodDisruptionBudget` | `72` | ۲ |
| `NetworkPolicy`ها | `80`، `81`، `82` | ۴ |
| `Job` و `CronJob` | `90`، `91` | ۴ |
| رعایت `namespace` در همهٔ منابع | همه | ۲ |
# **آنچه باید آپلود کنید**
کل پوشهٔ پروژه را *ZIP* کنید و بفرستید. پوشهٔ `k8s/` باید در ریشهٔ آرشیو باشد، **نه یک سطح تودرتوتر، در غیر این صورت نمره صفر را دریافت خواهید کرد!**
+ **توجه:** اسم فایلها باید دقیقاً همانهایی باشد که در فهرست بالا آمده. فایلی با اسم دیگر اصلاً خوانده نمیشود.
+ **توجه:** سیستم داوری هیچ کلاستری بالا نمیآورد و هیچ پادی اجرا نمیشود. فقط فایلها خوانده و بررسی میشوند.
+ **توجه:** همهٔ منابعی که `namespace` میخواهند باید در `jaam-rasadkhane` باشند و اسمهای جدول بالا رعایت شوند، چون منابع دیگر با همین اسمها همدیگر را پیدا میکنند.
+ **توجه:** عددهای دلخواه سنجیده نمیشوند؛ چیزی که مهم است درست وصل بودن منابع به هم و پذیرفته شدن در `kubeconform` است.