
سلام دوست عزیز😃👋
به «مسابقه مقدماتی المپیک فناوری ۲۰۲۶ - Devops» خوش آمدی!
هرگونه **ارتباط با سایر شرکتکنندگان** و یا **استفاده از ابزارهای تولید کد، مثل chatGPT و...** در مسابقات کوئرا ممنوع است و بعد از شناسایی **از لیست شرکتکنندگان مسابقه حذف میشوید**.
در صورت احراز هرگونه **تقلب یا تخلف در طول مسابقه**، دسترسی فرد یا تیم متخلف بلافاصله مسدود شده و از ادامه حضور در مسابقه **محروم (Ban)** خواهند شد.
ارسال راهحل توسط **هر یک از اعضای تیم**، بهصورت خودکار برای کل تیم ثبت و محاسبه میشود؛ بنابراین نیازی به ارسال مجدد یک سوال توسط هر دو نفر نیست.
لینکهای مفید برای شرکت در مسابقه:
+ [قوانین شرکت در مسابقه](https://quera.org/course/assignments/2693/problems/33523)
+ [قالب صورت سوالات تکنولوژی](https://quera.org/course/assignments/2693/problems/16283)
در طول مسابقه، میتوانید سؤالات خود را از قسمت «[سوال بپرسید](https://quera.org/contest/clarification/103145/)» مطرح کنید.
لیست سوالات را میتوانید از نوار سمت راست این صفحه مشاهده کنید.
موفق باشید و بهتون خوش بگذره 😉✌
| پروژهٔ اولیهٔ این سوال را میتوانید از [این لینک](/contest/assignments/103145/download_problem_initial_project/356754/) دانلود کنید. |
| :-: |
تابلوی نتایج **جام جهانی فناوری پردیس ۲۰۲۶** قرار است روی یک کلاستر **کوبرنتیزی** بالا بیاید. یک سرویس *API* که نتایج را میدهد، سه تا ورکر که رویدادهای بازی را پردازش میکنند، یک ردیس، یک پستگرس و یک پرومتئوس و گرافانا برای اینکه ببینیم همهچیز سالم است یا نه. همهٔ اینها باید فقط با فایلهای *YAML* توصیف شوند و نوشتن همین فایلها کار شماست!
|  |
| :-: |
| نمای کلی از رصدخانهٔ جام: `Ingress`، دیپلوی `stable` و `canary`، سه ورکر، ردیس و پستگرس و در آخر پرومتئوس و گرافانا. |
+ **چهل و چهار فایل زیاد بهنظر میرسد، ولی لازم نیست همه را پیادهسازی کنید!** بهجز دو بخشی که در بخش **«سابتسکها»** در انتهای سوال بهصورت **«صفر و یکی»** علامت خوردهاند، بقیهٔ بخشها مستقل نمره میگیرند: اگر مثلا سه فایل را پیادهسازی کنید، نمرهٔ همان سه بخش را میگیرید و نه کمتر و نه بیشتر!
- **ولی یک شرط دارد:** هر فایلی که میفرستید باید *YAML* درست و ریسورس معتبر کوبرنتیز باشد. سه درصد اول بهصورت **صفر و یکی** داده میشود و اگر حتی یک فایل ناقص یا با `kind` اشتباه بفرستید، همان سه درصد را کامل از دست میدهید. پس فایل نصفهکاره نفرستید و فایلی را که ننوشتهاید اصلاً **نسازید.**
- دو درصد امتیاز جداگانه هم برای کامل بودن مجموعه است و وقتی داده میشود که سیستم داوری کوئرا با استفاده از `kubeconform` دستکم **۳۵ ریسورس** ببیند. یعنی اگر دنبال نمرهٔ کامل هستید، باید عملاً بیشتر فایلها را پیادهسازی کرده باشید.
# **پروژهٔ اولیه**
برای دانلود **پروژهٔ اولیه** روی [این لینک](/contest/assignments/103145/download_problem_initial_project/356754/) کلیک کنید. پروژه یک پوشهٔ `k8s/` دارد و شما باید فایلهای *YAML* را داخلش بسازید.
+ **مهمترین نکتهٔ این سؤال:** سیستم داوری فقط فایلهایی را میخواند که **اسمشان دقیقاً** یکی از اسمهای فهرست زیر باشد. اگر اسم فایل را عوض کنید، آن فایل اصلاً خوانده نمیشود و نمرهٔ آن بخش صفر میماند.
+ **دومین نکتهٔ مهم، اسم خودِ منابع است.** تستها منابع را با اسمشان پیدا میکنند، نه با اینکه در کدام فایل نوشته شدهاند. این چند اسم اجباریاند و اگر فرق کنند آن ریسورس **«پیدا نشده»** حساب میشود:
| **ریسورس** | **اسم اجباری** |
| --: | --: |
| کانتینر اصلی داخل `Deployment` سرویس *API* | `api` |
| `PriorityClass` مربوط به کارهای بچ | `scoreboard-batch` |
| لیبلی که نسخهٔ `stable` را از `canary` جدا میکند | کلید `track` با مقدار `stable` یا `canary` |
| `Role` و `RoleBinding`ها | باید با `scoreboard` شروع شوند |
> اسم `Deployment`ها و `Service`ها را هم در همان جدولهای هر بخش آوردهایم. قاعدهٔ کلی این است که هر چیزی با پیشوند `scoreboard` میآید، بهجز پرومتئوس و گرافانا که اسمشان `prometheus` و `grafana` است.
<details class="grey">
<summary>**نکته: فهرست دقیق فایلهایی که باید بسازید**</summary>
در هر فایل میتوانید بیش از یک ریسورس بگذارید و با `---` از هم جدایشان کنید. ولی اسم فایل باید دقیقاً یکی از اینها باشد:
```
k8s/
├── <mark class="green" title="باید پیادهسازی شود">00-namespace.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">01-priorityclass.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">02-resourcequota.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">03-limitrange.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">04-storageclass.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">05-crd-vpa.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">06-crd-servicemonitor.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">10-configmap-app.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">11-configmap-proxy.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">12-configmap-prometheus.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">13-configmap-grafana.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">14-secret-db.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">15-secret-api.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">16-secret-tls.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">20-rbac-serviceaccounts.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">21-rbac-roles.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">22-rbac-clusterrole.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">23-rbac-bindings.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">30-api-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">31-api-service.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">32-ingester-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">33-aggregator-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">34-notifier-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">35-worker-services.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">36-api-canary-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">40-redis-statefulset.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">41-redis-service.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">42-postgres-statefulset.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">43-postgres-service.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">50-prometheus-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">51-prometheus-service.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">52-grafana-deployment.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">53-grafana-service.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">54-servicemonitor.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">60-ingress.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">70-hpa.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">71-vpa.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">72-pdb.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">80-netpol-default-deny.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">81-netpol-redis.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">82-netpol-db.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">83-netpol-api.yml</mark>
├── <mark class="green" title="باید پیادهسازی شود">90-job-migrate.yml</mark>
└── <mark class="green" title="باید پیادهسازی شود">91-cronjob-archive.yml</mark>
```
</details>
# **جزئیات**
## **داوری چطور کار میکند**
سیستم داوری کوئرا **هیچ کلاستری بالا نمیآورد و هیچ پادی را اجرا نمیکند! عملا به دلیل حجم بالای شرکتکنندهها این کار به کل امکان پذیر نخواهد بود.** سیستم داوری فایلهای *YAML* شما را میخواند و نگاه میکند که منابع درست به هم وصل شدهاند یا نه. این کار شدنی است چون در کوبرنتیز همهچیز داخل خود *YAML* نوشته میشود: اینکه `selector` یک `Service` کدام پادها را میگیرد، اینکه `scaleTargetRef` یک `HorizontalPodAutoscaler` به کدام `Deployment` اشاره میکند، همه در فایل هست. در آخر هم اسکیمای فایلها را با `kubeconform` راستیآزمایی میکند.
+ **توجه:** عددهای دلخواه مثل تعداد رپلیکا، درصد *CPU* یا مقدار حافظه سنجیده **نمیشوند**. آنچه سنجیده میشود این است که منابع درست به هم وصل شده باشند.
+ **توجه:** اسم ایمیجها فقط یک رشتهٔ متنی است و هیچ ایمیجی پول یا اجرا نمیشود. هر اسمی بگذارید مشکلی ندارد.
همهٔ منابعی که `namespace` میخواهند باید داخل `jaam-rasadkhane` تعریف شوند. این اسمها هم قراردادیاند، چون هم منابع دیگر و هم سیستم داوری با همین اسمها دنبالشان میگردند:
| **چیزی که میسازید** | **اسمی که باید بگذارید** |
| --: | --: |
| `Namespace` | `jaam-rasadkhane` |
| `Deployment` و `Service` سرویس *API* | `scoreboard-api` |
| `Deployment` کاناری | `scoreboard-api-canary` |
| `StatefulSet` و `Service` ردیس | `redis` |
| `StatefulSet` و `Service` پستگرس | `scoreboard-db` |
| سه ورکر | `scoreboard-ingester` و `scoreboard-aggregator` و `scoreboard-notifier` |
| پرومتئوس و گرافانا | `prometheus` و `grafana` |
| `ConfigMap` برنامه | `scoreboard-config` |
| `ConfigMap` پرومتئوس | `prometheus-config` |
| `Secret` پستگرس | `scoreboard-db-secret` |
| `Secret` توکن *API* | `scoreboard-api-token` |
| `ServiceAccount`ها | `scoreboard-api-sa` و `scoreboard-worker-sa` و یکی برای پرومتئوس |
لیبلها هم بخشی از قرارداداند، چون `Service` و `NetworkPolicy` و `ServiceMonitor` با همینها همدیگر را پیدا میکنند. روی پادهای *API* این دو لیبل را بگذارید:
```yaml k8s/30-api-deployment.yml kubernetes
labels:
app: scoreboard
component: api
```
> همین جفت باید هم در `spec.selector.matchLabels` دیپلویمنت، هم در `spec.template.metadata.labels` پاد و هم در `selector` سرویس `scoreboard-api` تکرار شود. برای سه ورکر و لایهٔ داده هم `app` را `scoreboard` نگه دارید و فقط `component` را عوض کنید، مثلاً `ingester` یا `redis`. لیبل نسخه که برای کاناری لازم است جدا از این دوتاست و **نباید** داخل `selector` سرویس بیاید.
|  |
| :-: |
| معماری سیستم: `Ingress`، پادهای *API* با `initContainers` و سایدکار، سه ورکر، ردیس و پستگرس، پرومتئوس و گرافانا. |
## **فایلهای** `Namespace` **و** `PriorityClass`
<details class="blue">
<summary>**فایلهای `00-namespace.yml` و `01-priorityclass.yml`**</summary>
یک `Namespace` به اسم `jaam-rasadkhane` بسازید و چند لیبل توصیفی رویش بگذارید. این `Namespace` باید لیبلهای *Pod Security Admission* را هم داشته باشد تا پادهای ناامن داخلش قبول نشوند:
```yaml k8s/00-namespace.yml kubernetes
apiVersion: v1
kind: Namespace
metadata:
name: jaam-rasadkhane
labels:
app: scoreboard
pod-security.kubernetes.io/enforce: baseline
pod-security.kubernetes.io/audit: baseline
pod-security.kubernetes.io/warn: baseline
```
> سه لیبلی که با `pod-security.kubernetes.io/` شروع میشوند همان چیزی هستند که کوبرنتیز برای *Pod Security Admission* نگاه میکند. لیبل `enforce` جلوی ساخته شدن پاد ناامن را میگیرد و دوتای دیگر فقط هشدار میدهند. اسم `Namespace` باید دقیقاً `jaam-rasadkhane` باشد چون بقیهٔ فایلها به آن ارجاع میدهند.
>
> **یک نکتهٔ مهم:** چون در این سوال هیچ کلاستری اجرا نمیشود، این لیبلها **بهصورت متنی** بررسی میشوند و واقعاً روی پادها اعمال نمیشوند. یعنی لازم نیست همهٔ کانتینرهای همهٔ سرویسها را با سطح `restricted` سازگار کنید؛ فقط جایی که متن صریحاً `securityContext` خواسته، یعنی کانتینر اصلی *API*، آن را بنویسید. هر سه لیبل باید مقدار یکسانی داشته باشند و هر سه سطح معتبر (`privileged`، `baseline` یا `restricted`) پذیرفته میشود.
بعد **سه** `PriorityClass` بسازید که عددشان با هم فرق دارد. `PriorityClass` اهمیت یک پاد را برای `scheduler` مشخص میکند: پاد با اولویت بالاتر زودتر زمانبندی میشود و در صورت کمبود منابع میتواند باعث *preemption* پادهای کماولویتتر شود.
- یکی با عدد بالا، برای پادهای مهم مثل سرویس *API* و پستگرس.
- یکی با عدد متوسط، برای ورکرها و پرومتئوس و گرافانا.
- یکی با عدد پایین، برای `Job` و `CronJob`.
پادهای *API* باید از کلاس عدد بالا استفاده کنند و `Job` و `CronJob` از کلاس عدد پایین. فقط ترتیب نسبی `high > medium > low` سنجیده میشود و مقدار عددی هرکدام دلخواه است.
</details>
## **فایل** `ResourceQuota` **و** `LimitRange`
<details class="green">
<summary>**فایلهای `02-resourcequota.yml` و `03-limitrange.yml`**</summary>
یک `ResourceQuota` بسازید که **هر دو** چیز زیر را داشته باشد:
- سقف مجموع *CPU* و حافظه، هم برای `requests` و هم برای `limits`.
- سقف تعداد اشیا، مثلاً تعداد پاد یا `Service` یا `Secret`.
بعد یک `LimitRange` بسازید که برای کانتینرهای این `Namespace` مقدار پیشفرض و حداقل و حداکثر *CPU* و حافظه را مشخص کند، تا هیچ کانتینری بدون `limits` بالا نیاید. عددها دلخواه شماست و فقط وجود این سه چیز چک میشود.
</details>
## **فایل** `StorageClass`
<details class="yellow">
<summary>**فایل `04-storageclass.yml`**</summary>
یک `StorageClass` بسازید که فیلد `provisioner` داشته باشد. این ریسورس مشخص میکند `PersistentVolume`ها چطور بهصورت خودکار ساخته شوند و `reclaimPolicy` آنها بعد از آزاد شدن از `PersistentVolumeClaim` چه باشد.
هر دو `volumeClaimTemplate` ردیس و پستگرس باید `storageClassName` را برابر اسم همین `StorageClass` بگذارند.
</details>
## **فایل** `ConfigMap` و `Secret`
<details class="violet">
<summary>**فایلهای `10` تا `16`**</summary>
چیزهای معمولی داخل `ConfigMap` و چیزهای حساس داخل `Secret`. چهار `ConfigMap` بسازید:
| **فایل** | **اسم** `ConfigMap` | **داخلش چه باید باشد** |
| --: | --: | --: |
| `10-configmap-app.yml` | `scoreboard-config` | کلید `REDIS_ADDR` با آدرس ردیس و کلید `DB_HOST` با آدرس پستگرس، بهاضافهٔ هر کلید دیگری که لازم دارید |
| `11-configmap-proxy.yml` | هر اسمی | کانفیگ کانتینر سایدکار |
| `12-configmap-prometheus.yml` | `prometheus-config` | کانفیگ پرومتئوس که حتماً بخش `scrape_configs` را داشته باشد |
| `13-configmap-grafana.yml` | هر اسمی | تعریف *datasource* گرافانا |
و سه `Secret`:
| **فایل** | **اسم** `Secret` | `type` | **کلیدها** |
| --: | --: | --: | --: |
| `14-secret-db.yml` | `scoreboard-db-secret` | `Opaque` | `POSTGRES_USER` و `POSTGRES_PASSWORD` |
| `15-secret-api.yml` | `scoreboard-api-token` | `Opaque` | توکن سرویس *API* |
| `16-secret-tls.yml` | هر اسمی | `kubernetes.io/tls` | `tls.crt` و `tls.key` |
```yaml k8s/14-secret-db.yml kubernetes
apiVersion: v1
kind: Secret
metadata:
name: scoreboard-db-secret
namespace: jaam-rasadkhane
type: Opaque
data:
POSTGRES_USER: c2NvcmVib2FyZA==
POSTGRES_PASSWORD: cGFyZGlzLTIwMjYtc2VjcmV0
```
> حتماً از کلید `data` استفاده کنید و نه `stringData`. هر دو روی یک کلاستر واقعی کار میکنند، ولی چون در این سوال هیچ کلاستری اجرا نمیشود، تستها خودِ فایل شما را میخوانند و فقط داخل `data` را نگاه میکنند؛ با `stringData` نمرهٔ این بخش صفر میشود. مقدارها باید *base64* شده باشند و با `printf 'scoreboard' | base64` میتوانید بسازیدشان. اسم `scoreboard-db-secret` و اسم دو کلید `POSTGRES_USER` و `POSTGRES_PASSWORD` اجباریاند چون `StatefulSet` پستگرس از همینها میخواند. `Secret` مربوط به *TLS* باید `type` برابر `kubernetes.io/tls` داشته باشد؛ این همان نوعی است که `Ingress` برای گواهی انتظار دارد و داوری هم همین را میسنجد.
</details>
## **فایل** `ServiceAccount` **و** `RBAC`
<details class="blue">
<summary>**فایلهای `20` تا `23`**</summary>
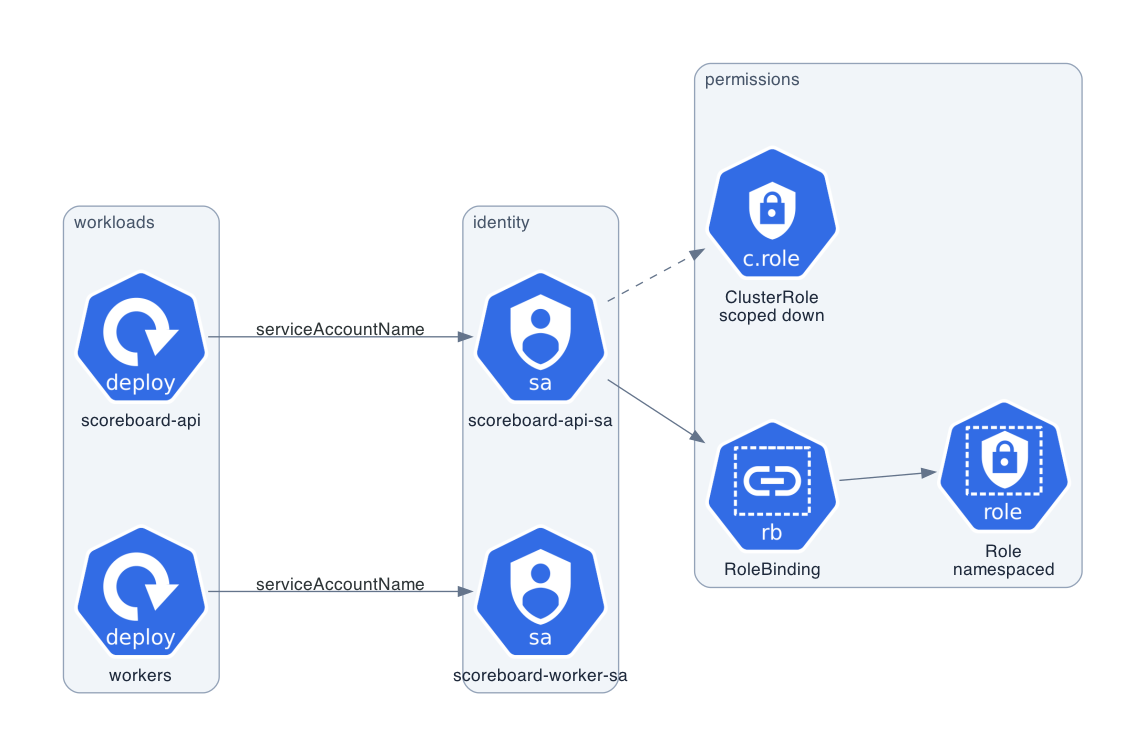
قاعده این است که هر سرویس فقط همان دسترسیای را داشته باشد که واقعاً لازم دارد. بهجای یک اکانت مشترک، برای هر کدام یک `ServiceAccount` جدا بسازید: دستکم `scoreboard-api-sa` برای *API*، `scoreboard-worker-sa` برای ورکرها و یکی برای پرومتئوس.
بعد دو سطح دسترسی بسازید:
- **دو `Role`** در `21-rbac-roles.yml`. `Role` فقط داخل همین `Namespace` کار میکند. مثلاً اجازهٔ `get` و `list` روی `configmaps` و `pods`. اجازهٔ نوشتن گسترده ندهید.
- **دو `ClusterRole`** در `22-rbac-clusterrole.yml`. `ClusterRole` در کل کلاستر کار میکند، پس دسترسی را تا حد ممکن محدود کنید. مثلاً فقط خواندن `nodes` برای پرومتئوس.
+ **توجه:** هیچکدام از این `Role`ها و `ClusterRole`ها نباید `*` روی `resources` و `verbs` بدهند. سیستم داوری همین را چک میکند.
```yaml k8s/22-rbac-clusterrole.yml kubernetes
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
name: scoreboard-prometheus-reader
rules:
- apiGroups: [""]
resources: ["nodes", "nodes/metrics", "services", "endpoints", "pods"]
verbs: ["get", "list", "watch"]
```
> این `ClusterRole` فقط اجازهٔ خواندن میدهد و هیچ فعل نوشتنی مثل `create` یا `delete` ندارد. رشتهٔ خالی در `apiGroups` یعنی گروه اصلی کوبرنتیز، جایی که `pods` و `services` در آن هستند. اگر بهجای این فهرست، `resources: ["*"]` و `verbs: ["*"]` بنویسید، تست مربوط به این بخش رد میشود.
در `23-rbac-bindings.yml` این نقشها را وصل کنید: یک `RoleBinding` برای `scoreboard-api-sa`، یک `RoleBinding` برای `scoreboard-worker-sa` و دستکم یک `ClusterRoleBinding`. هر `Deployment` هم باید در `spec.template.spec.serviceAccountName` اکانت خودش را بنویسد.
</details>
|  |
| :-: |
| سه `ServiceAccount`، هرکدام به `Role`ها و `ClusterRole`های محدود وصل میشوند. |
## **فایل** `Deployment` **سرویس** *API*
<details class="green">
<summary>**فایل `30-api-deployment.yml`، پرامتیازترین فایل این سؤال**</summary>
یک `Deployment` به اسم `scoreboard-api` با چند تا رپلیکا بسازید. دقت کنید `spec.selector.matchLabels` با لیبلهای `spec.template.metadata.labels` یکی باشد، وگرنه `Deployment` پادهای خودش را پیدا نمیکند.
کانتینر اصلی باید اینها را داشته باشد:
- پورت `8080`.
- خواندن کانفیگ از `scoreboard-config` و مقدارهای حساس از `Secret`ها.
- `livenessProbe` و `readinessProbe`.
- `resources` با هر دو بخش `requests` و `limits` برای *CPU* و حافظه.
- `securityContext` امن: `allowPrivilegeEscalation: false`، اجرا با کاربر غیر روت و یک `seccompProfile`.
```yaml k8s/30-api-deployment.yml kubernetes
securityContext:
allowPrivilegeEscalation: false
runAsNonRoot: true
runAsUser: 10001
capabilities:
drop: ["ALL"]
seccompProfile:
type: RuntimeDefault
```
> این تکه داخل کانتینر اصلی میآید. فیلد `allowPrivilegeEscalation: false` جلوی این را میگیرد که پروسه داخل کانتینر دسترسی خودش را بالا ببرد. فیلد `runAsNonRoot: true` به کوبرنتیز میگوید اگر ایمیج بخواهد با روت بالا بیاید اصلاً اجرایش نکند. مقدار `RuntimeDefault` برای `seccompProfile` هم فیلتر پیشفرض سیستمکالها را روشن میکند. بدون این چهار چیز، هم تست مربوط به امنیت رد میشود و هم `Namespace` با سطح `restricted` پاد را قبول نمیکند.
علاوه بر کانتینر اصلی، این پاد باید دو چیز دیگر هم داشته باشد:
- **بیش از یک `initContainer`.** اینها قبل از کانتینر اصلی اجرا میشوند و منتظر میمانند تا ردیس و پستگرس بالا بیایند. یعنی `initContainers` باید دستکم دو عضو داشته باشد.
- **یک کانتینر سایدکار** که کنار کانتینر اصلی در همان پاد بالا میآید، متریک میدهد و یک `containerPort` با `name: metrics` باز میکند.
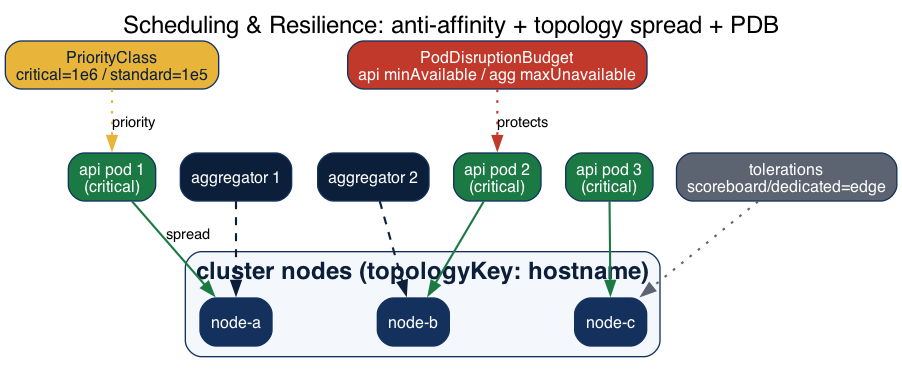
آخرین چیز، پادهای *API* نباید همه روی یک نود جمع شوند، چون اگر آن نود از کار بیفتد کل سرویس میخوابد. برای این کار `affinity` یا `podAntiAffinity` تعریف کنید و `topologySpreadConstraints` هم بگذارید.
</details>
|  |
| :-: |
| قواعد `podAntiAffinity` و `topologySpreadConstraints` پادهای *API* را روی نودها پخش میکنند و `PodDisruptionBudget` از آنها محافظت میکند. |
## **فایل** `Service` **مشترک و دیپلوی کاناری**
<details class="violet">
<summary>**فایلهای `31-api-service.yml` و `36-api-canary-deployment.yml`**</summary>
یک `Service` از نوع `ClusterIP` به اسم `scoreboard-api` بسازید که پادهای *API* را بگیرد و ترافیک را به پورت `8080` کانتینر برساند. `selector` این `Service` باید واقعاً با لیبلهای پادهای *API* بخواند، چون سیستم داوری همین تطابق را چک میکند.
حالا برای اینکه بشود نسخهٔ جدید *API* را روی سهم کوچکی از ترافیک امتحان کرد، یک `Deployment` دوم به اسم `scoreboard-api-canary` بسازید. ساختارش شبیه دیپلویمنت اصلی است، با این تفاوتها:
- دیپلویمنت اصلی باید یک لیبل نسخه با مقدار `stable` داشته باشد و کاناری همان لیبل را با مقدار `canary`.
- تعداد رپلیکای کاناری باید **کمتر** از رپلیکای اصلی باشد.
- کاناری هم باید همان `scoreboard-config` را بخواند.
+ **کل نکتهٔ این بخش این است:** یک `Service` مشترک باید **هر دو** دیپلویمنت را بگیرد. یعنی `selector` سرویس فقط روی لیبلهای مشترک مثل `app` و `component` باشد و **نباید** لیبل نسخه را فیلتر کند.
```yaml k8s/31-api-service.yml kubernetes
spec:
type: ClusterIP
selector:
app: scoreboard
component: api
ports:
- name: http
port: 80
targetPort: 8080
```
> این `selector` عمداً لیبل نسخه را ندارد. به همین دلیل هم پادهای `stable` و هم پادهای `canary` وارد `Endpoints` این `Service` میشوند. در عمل سهم هر نسخه به تعداد `Endpoint`های آمادهٔ آن نسخه بستگی دارد، ولی کوبرنتیز درصد دقیق و ثابتی برای هر نسخه تضمین نمیکند؛ برای وزندهی دقیق به یک لایهٔ مسیریابی جداگانه نیاز است. اگر لیبل نسخه را داخل `selector` بگذارید، سرویس فقط یکی از دو نسخه را میگیرد و تست این بخش رد میشود.
</details>
## **فایل ورکرها**
<details class="blue">
<summary>**فایلهای `32` تا `35`**</summary>
سه `Deployment` جدا بسازید:
| **فایل** | **اسم** `Deployment` | **وظیفه** |
| --: | --: | --: |
| `32-ingester-deployment.yml` | `scoreboard-ingester` | گرفتن و چک کردن رویدادهای بازی |
| `33-aggregator-deployment.yml` | `scoreboard-aggregator` | جمع کردن امتیاز و گل |
| `34-notifier-deployment.yml` | `scoreboard-notifier` | فرستادن اعلان |
هر سه باید کانفیگ را از `scoreboard-config` بگیرند، با `scoreboard-worker-sa` اجرا شوند، `resources.requests` داشته باشند و یک `containerPort` با `name: metrics` باز کنند. این ورکرها سرور *HTTP* عمومی ندارند و فقط در پسزمینه کار میکنند.
در `35-worker-services.yml` برای هر ورکر یک `Service` بسازید که پورت `metrics` را عرضه کند، تا پرومتئوس بتواند از آنها متریک بخواند. تعداد رپلیکاها دلخواه شماست.
</details>
|  |
| :-: |
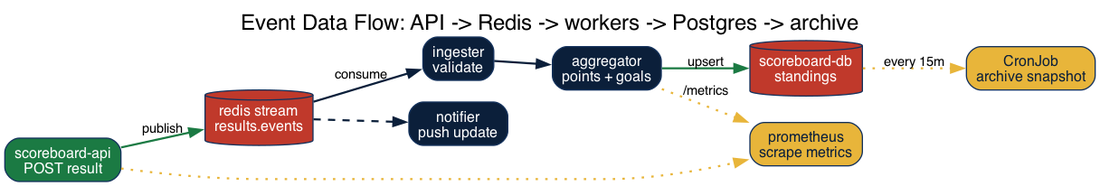
| مسیر یک رویداد: از *API* به ردیس، مصرف توسط ورکرها، ذخیره در پستگرس و بازتاب در متریکها. |
## **فایلهای ردیس و پستگرس**
<details class="green">
<summary>**فایلهای `40` تا `43`**</summary>
ردیس و پستگرس داده نگه میدارند، پس بهجای `Deployment` باید `StatefulSet` باشند. `StatefulSet` برای هر پاد یک هویت پایدار و یک `PersistentVolumeClaim` اختصاصی میسازد، بنابراین پاد بعد از ساخته شدن دوباره به همان ولوم قبلی وصل میشود.
**ردیس** را در `40-redis-statefulset.yml` بهصورت `StatefulSet` با اسم `redis` بنویسید که:
- فیلد `serviceName` آن `redis` باشد.
- کانتینر ردیس روی پورت `6379` باشد.
- یک `volumeClaimTemplate` داشته باشد.
بعد در `41-redis-service.yml` یک `Service` با `clusterIP: None` و اسم `redis` بسازید:
```yaml k8s/41-redis-service.yml kubernetes
apiVersion: v1
kind: Service
metadata:
name: redis
namespace: jaam-rasadkhane
spec:
clusterIP: None
selector:
app: scoreboard
component: redis
ports:
- name: redis
port: 6379
targetPort: 6379
```
> فیلد `clusterIP: None` این `Service` را *headless* میکند. یعنی کوبرنتیز برایش یک *IP* مجازی نمیسازد و بهجایش برای هر پاد یک رکورد *DNS* جدا میسازد. `StatefulSet` دقیقاً به همین احتیاج دارد تا هر پاد اسم پایدار خودش را داشته باشد و بعد از ریاستارت هم با همان اسم پیدا شود. اسم این `Service` باید با `serviceName` داخل `StatefulSet` یکی باشد، وگرنه اسمهای *DNS* ساخته نمیشوند.
**پستگرس** را در `42-postgres-statefulset.yml` بهصورت `StatefulSet` با اسم `scoreboard-db` بنویسید که روی پورت `5432` باشد، یوزر و پسورد را از `scoreboard-db-secret` بگیرد و آن هم `volumeClaimTemplate` داشته باشد. بعد در `43-postgres-service.yml` یک `Service` معمولی با اسم `scoreboard-db` روی پورت `5432` بسازید.
</details>
## **فایلهای پرومتئوس و گرافانا**
<details class="violet">
<summary>**فایلهای `50` تا `54` و `06`**</summary>
یک `Deployment` به اسم `prometheus` بسازید که `prometheus-config` را بهصورت ولوم مانت کند، با `ServiceAccount` خودش اجرا شود و `Service` آن روی پورت `9090` باشد. پرومتئوس باید بتواند پورت `metrics` سرویس *API* و هر سه ورکر را بخواند.
کنارش یک `Deployment` به اسم `grafana` بسازید که پسورد ادمینش را از یک `Secret` بگیرد و `Service` آن روی پورت `3000` باشد.
بعد `ServiceMonitor` را اضافه کنید. `ServiceMonitor` ریسورس استاندارد کوبرنتیز نیست؛ ریسورسی سفارشی است که *Prometheus Operator* تعریف میکند. روی یک کلاستر واقعی، تا `CRD` آن اعمال نشده باشد سرور *API* چنین ریسورسی را نمیشناسد. در این سوال کلاستری اجرا نمیشود، ولی چون بخشی از کار همین اعلام کردن قرارداد ریسورس است، هر دو فایل خواسته میشوند:
- در `06-crd-servicemonitor.yml` تعریف `CustomResourceDefinition` مربوط به `ServiceMonitor` را بگذارید.
- در `54-servicemonitor.yml` یک ریسورس `ServiceMonitor` بسازید که با `selector` خودش دستکم `Service` سرویس *API* را برای خواندن متریک انتخاب کند.
+ **توجه:** بدون فایل `06`، ریسورس داخل فایل `54` بیمعنی است و تست این بخش رد میشود. هر دو فایل لازماند.
</details>
|  |
| :-: |
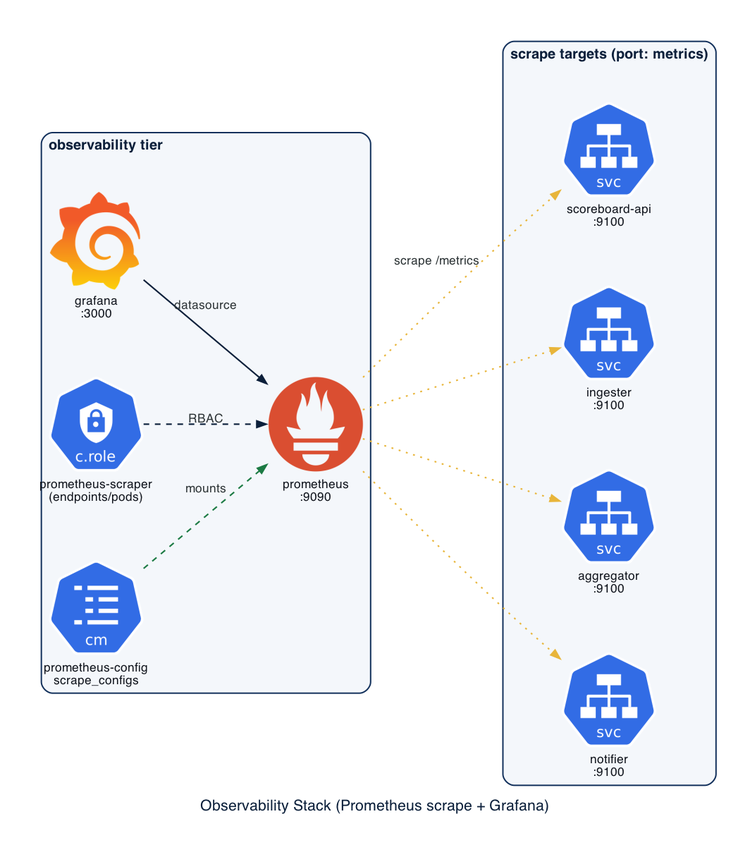
| پرومتئوس پورت `metrics` سرویس *API* و ورکرها را میخواند و گرافانا آن را بهعنوان *datasource* نشان میدهد. |
## **فایل** *Ingress*
<details class="blue">
<summary>**فایل `60-ingress.yml`**</summary>
یک `Ingress` بسازید که ترافیک بیرون را به `Service` با اسم `scoreboard-api` بفرستد و یک بخش `tls` داشته باشد که به `Secret` مربوط به *TLS* اشاره میکند. یک `host` و `path` هم تعریف کنید و اگر لازم شد `ingressClassName` را بنویسید. `Ingress` باعث میشود بهجای باز کردن مستقیم سرویسها به بیرون، فقط یک در ورودی داشته باشیم.
</details>
|  |
| :-: |
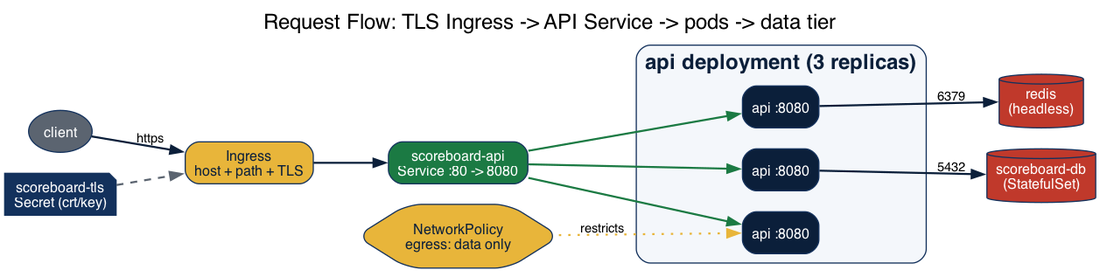
| مسیر کامل درخواست از `Ingress` با *TLS* تا پادهای *API* و پستگرس، محدودشده با `NetworkPolicy`. |
## **فایلهای اتواسکیلینگ**
<details class="green">
<summary>**فایلهای `70-hpa.yml` و `71-vpa.yml` و `05-crd-vpa.yml`**</summary>
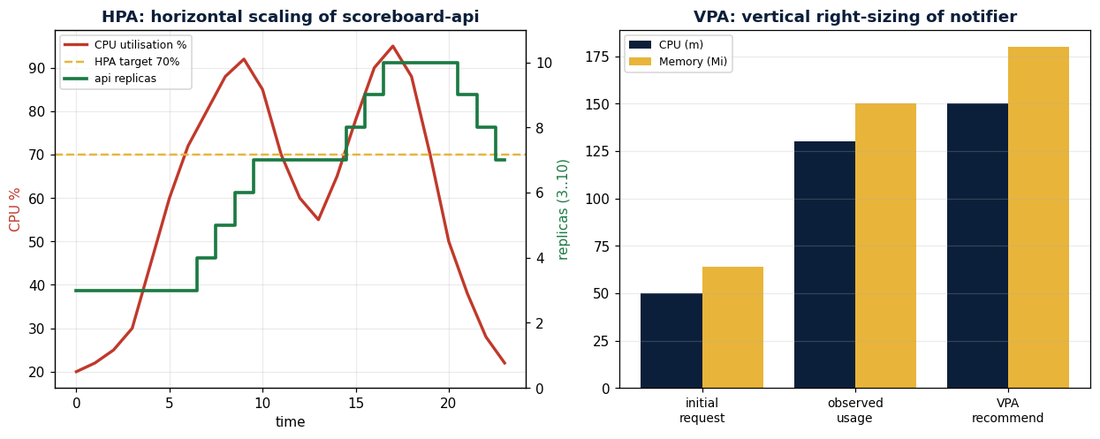
در `70-hpa.yml` **دو** `HorizontalPodAutoscaler` بسازید، یکی برای `scoreboard-api` و یکی برای `scoreboard-aggregator`. هرکدام باید:
- `minReplicas` و `maxReplicas` داشته باشند، طوری که `maxReplicas` از `minReplicas` کوچکتر نباشد.
- دستکم یک `metrics` تعریف کنند، مثلاً مصرف *CPU*.
- در `scaleTargetRef` اسم درست `Deployment` را بنویسند.
```yaml k8s/70-hpa.yml kubernetes
spec:
scaleTargetRef:
apiVersion: apps/v1
kind: Deployment
name: scoreboard-api
minReplicas: 3
maxReplicas: 10
metrics:
- type: Resource
resource:
name: cpu
target:
type: Utilization
averageUtilization: 70
```
> بخش `scaleTargetRef` میگوید این *HPA* روی کدام `Deployment` کار کند و اسمش باید دقیقاً با اسم دیپلویمنت یکی باشد. بخش `metrics` هم معیار را مشخص میکند: اینجا اگر میانگین مصرف *CPU* پادها از ۷۰ درصدِ `requests` بالاتر برود، تعداد رپلیکا زیاد میشود. دقت کنید که *HPA* برای کار کردن به `resources.requests` روی کانتینر احتیاج دارد، پس اگر آن را ننوشته باشید در عمل کار نمیکند.
در `71-vpa.yml` یک `VerticalPodAutoscaler` بسازید که یکی از سرویسها را هدف بگیرد. *VPA* هم مثل `ServiceMonitor` یک ریسورس سفارشی است، پس `CRD` آن را در `05-crd-vpa.yml` بگذارید.
</details>
|  |
| :-: |
| *HPA* تعداد رپلیکاها را با بار تنظیم میکند و *VPA* اندازهٔ منابع هر پاد را. |
## **فایل** `PodDisruptionBudget`
<details class="yellow">
<summary>**فایل `72-pdb.yml`**</summary>
`PodDisruptionBudget` مشخص میکند هنگام *voluntary disruption*، مثلاً `kubectl drain` روی یک نود، حداکثر چند پاد از یک سرویس میتوانند همزمان از دسترس خارج شوند. این ریسورس جلوی خراب شدن ناگهانی نود یا حذف مستقیم پاد توسط ادمین را نمیگیرد.
دستکم **دو** بسازید که لایههای مختلف را پوشش دهند. یکی از آنها حتماً باید پادهای *API* را هدف بگیرد و با `minAvailable` یا `maxUnavailable` حد را مشخص کند. عددها دلخواه شماست.
</details>
## **فایل** `NetworkPolicy`
<details class="violet">
<summary>**فایلهای `80` تا `83`**</summary>
بهصورت پیشفرض در کوبرنتیز هر پاد میتواند به هر پاد دیگری وصل شود. با `NetworkPolicy` این را میبندیم و فقط چیزهای لازم را باز میکنیم:
- در `80-netpol-default-deny.yml` یک `NetworkPolicy` بسازید که کل `Namespace` را هدف بگیرد و **هم `Ingress` و هم `Egress`** را ببندد.
- در `81-netpol-redis.yml` یک سیاست برای پادهای ردیس که **هر دو جهت** را محدود کند: فقط پادهای این سیستم اجازهٔ اتصال روی پورت `6379` داشته باشند.
+ **دو سیاست ردیس و پایگاهداده با لیبل هدفگیری میشوند.** `podSelector` هرکدام باید دقیقاً روی `component: redis` و `component: db` بنشیند و `policyTypes` هر دو باید **هم `Ingress` و هم `Egress`** را داشته باشد. اگر لیبل دیگری بگذارید، سیاست پیدا نمیشود؛ پس مطمئن شوید پادهای ردیس و پستگرس هم همین لیبل `component` را روی خودشان دارند.
- در `82-netpol-db.yml` همین کار را برای پستگرس بکنید، باز هم با محدود کردن هر دو جهت.
- در `83-netpol-api.yml` سیاست مربوط به پادهای *API*. این فایل نمرهٔ مستقلی ندارد و اختیاری است، ولی برای کامل بودن مدل امنیتی توصیه میشود.
```yaml k8s/80-netpol-default-deny.yml kubernetes
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
name: default-deny-all
namespace: jaam-rasadkhane
spec:
podSelector: {}
policyTypes:
- Ingress
- Egress
```
> فیلد `podSelector: {}` یعنی این سیاست روی **همهٔ** پادهای این `Namespace` اعمال میشود. چون `policyTypes` هر دو مقدار `Ingress` و `Egress` را دارد ولی هیچ قانون `ingress` یا `egress` نوشته نشده، نتیجهاش بستن کامل هر دو جهت است. بعد از این فایل، هر ارتباطی که واقعاً لازم دارید را باید در فایلهای `81` تا `83` صریحاً باز کنید. سیستم داوری وجود همین سیاست پیشفرض و پوشش هر دو جهت در سیاستهای ردیس و پستگرس را چک میکند.
</details>
|  |
| :-: |
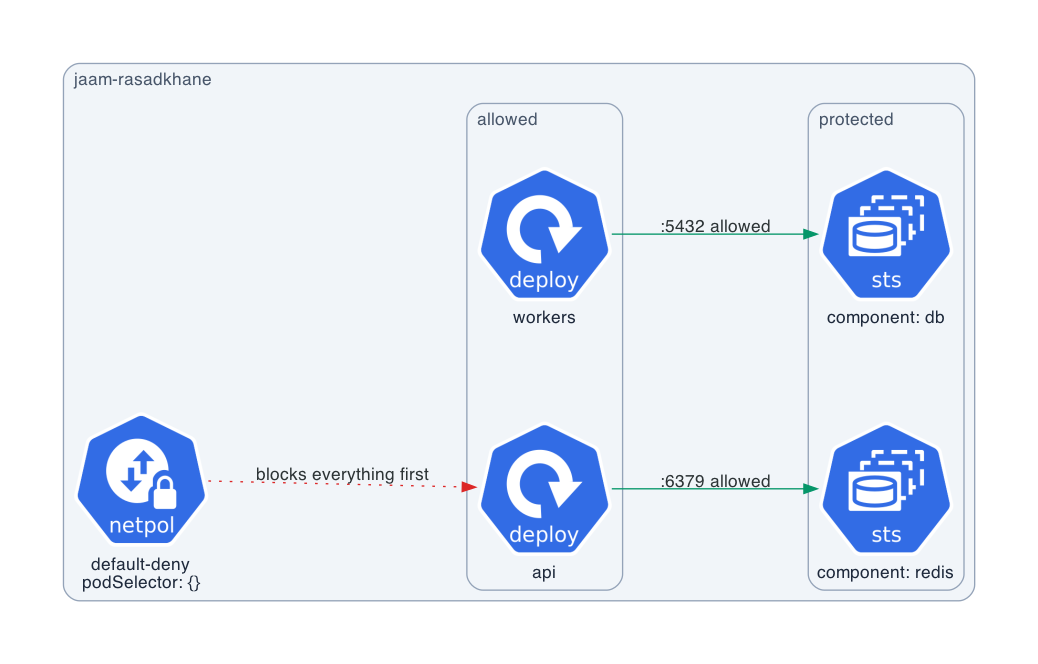
| لیبلهای *Pod Security*، `securityContext` کانتینرها، `NetworkPolicy`ها و `RBAC` محدود در کنار هم. |
## **فایلهای** `Job` و `CronJob`
<details class="blue">
<summary>**فایلهای `90-job-migrate.yml` و `91-cronjob-archive.yml`**</summary>
دو تا کار پسزمینه تعریف کنید:
- در `90-job-migrate.yml` یک `Job` یکباره برای مایگریشن دیتابیس. فیلد `restartPolicy` پادش باید `OnFailure` یا `Never` باشد (مقدار پیشفرض `Always` است و `Job` قبولش نمیکند). قبل از کانتینر اصلی هم یک `initContainer` بگذارید که منتظر بالا آمدن پستگرس بماند.
- در `91-cronjob-archive.yml` یک `CronJob` برای بایگانی دورهای با یک `schedule` معتبر. `restartPolicy` داخل قالب کارش هم باید `OnFailure` یا `Never` باشد.
هر دو با `scoreboard-worker-sa` اجرا میشوند و باید `priorityClassName` را روی همان کلاس عدد پایین بگذارند تا موقع کمبود منابع زودتر از سرویسهای اصلی کنار بروند.
</details>
# **بررسی وضعیت اسکیماها**
بعد از نوشتن فایلها میتوانید خودتان اسکیمایشان را با `kubeconform` چک کنید. این همان کاری است که سیستم داوری در آخر انجام میدهد:
```bash terminal terminal
kubeconform -summary -ignore-missing-schemas k8s/*.yml
```
> این دستور همهٔ فایلهای پوشهٔ `k8s/` را میخواند و هر ریسورس را با اسکیمای رسمی کوبرنتیز مقایسه میکند. فلگ `-ignore-missing-schemas` باعث میشود منابع سفارشی مثل `VerticalPodAutoscaler` و `ServiceMonitor` که اسکیمای عمومی ندارند بهجای خطا دادن در دستهٔ `Skipped` بروند. خروجی موفق چیزی شبیه خط زیر است و عددها بسته به اینکه چند تکه را نوشتهاید فرق میکند.
```text output terminal
Summary: 61 resources found in 44 files - Valid: 56, Invalid: 0, Errors: 0, Skipped: 5
```
جدا از اسکیما، سیستم داوری وصل بودن منابع به هم را هم چک میکند. مثلاً میبیند `selector` سرویس *API* واقعاً پادهای دیپلویمنت *API* را میگیرد یا نه:
```text output terminal
service/scoreboard-api selector: {app: scoreboard, component: api} -> 3 api pods
```
و اینکه `scaleTargetRef` مربوط به *HPA* واقعاً به دیپلویمنت *API* اشاره میکند یا نه:
```text output terminal
hpa/scoreboard-api-hpa scaleTargetRef -> Deployment/scoreboard-api min:3 max:10
```
> این دو خط نمونهای از چیزی هستند که سیستم داوری از روی *YAML* بیرون میکشد. اگر لیبلهای پاد با `selector` سرویس نخوانند یا اسم داخل `scaleTargetRef` اشتباه باشد، آن بخش رد میشود حتی اگر فایل از نظر اسکیما کاملاً معتبر باشد. به همین دلیل رعایت اسمهای جدول بالا مهم است.
## **سابتسکها**
هر ردیف در سیستم داوری مستقل نمره میگیرد. از این جدول برای انتخاب مسیر خودتان استفاده کنید:
| **بخش** | **فایلها** | **درصد** |
| --: | --: | :-: |
| ارسال معتبر و رد شدن از `kubeconform` | همه | ۵ |
| `Namespace` و لیبلهای *Pod Security* | `00` | ۲ |
| سه `PriorityClass` و کلاس بچ | `01` | ۴ |
| `ResourceQuota` و `LimitRange` | `02`، `03` | ۴ |
| `StorageClass` | `04` | ۲ |
| `ConfigMap`ها | `10` تا `13` | ۴ |
| `Secret`ها | `14`، `15`، `16` | ۵ |
| `ServiceAccount` و `Role` و `ClusterRole` و بایندینگها | `20` تا `23` | ۸ |
| `Deployment` سرویس *API* | `30` | ۱۴ |
| `Service` مشترک *API* | `31` | ۲ |
| سه ورکر و `Service` متریکشان | `32` تا `35` | ۸ |
| دیپلوی کاناری | `36`، `13` | ۵ |
| ردیس و پستگرس | `40` تا `43` | ۸ |
| پرومتئوس و گرافانا | `50` تا `53` | ۸ |
| `ServiceMonitor` و *CRD* آن | `06`، `54` | ۳ |
| `Ingress` با *TLS* | `60` | ۲ |
| `HorizontalPodAutoscaler` و `VerticalPodAutoscaler` | `70`، `71`، `05` | ۴ |
| `PodDisruptionBudget` | `72` | ۲ |
| `NetworkPolicy`ها | `80`، `81`، `82` | ۴ |
| `Job` و `CronJob` | `90`، `91` | ۴ |
| رعایت `namespace` در همهٔ منابع | همه | ۲ |
# **آنچه باید آپلود کنید**
کل پوشهٔ پروژه را *ZIP* کنید و بفرستید. پوشهٔ `k8s/` باید در ریشهٔ آرشیو باشد، **نه یک سطح تودرتوتر، در غیر این صورت نمره صفر را دریافت خواهید کرد!**
+ **توجه:** اسم فایلها باید دقیقاً همانهایی باشد که در فهرست بالا آمده. فایلی با اسم دیگر اصلاً خوانده نمیشود.
+ **توجه:** سیستم داوری هیچ کلاستری بالا نمیآورد و هیچ پادی اجرا نمیشود. فقط فایلها خوانده و بررسی میشوند.
+ **توجه:** همهٔ منابعی که `namespace` میخواهند باید در `jaam-rasadkhane` باشند و اسمهای جدول بالا رعایت شوند، چون منابع دیگر با همین اسمها همدیگر را پیدا میکنند.
+ **توجه:** عددهای دلخواه سنجیده نمیشوند؛ چیزی که مهم است درست وصل بودن منابع به هم و پذیرفته شدن در `kubeconform` است.
رصدخانه تمامکوبری
ارسال پاسخ برای این سؤال
در حال حاضر شما دسترسی ندارید.